
แนวปฏิบัติ AI Security Guidelines ของ สกมช.
สรุปแนวปฏิบัติการใช้ปัญญาประดิษฐ์อย่างมั่นคงปลอดภัยของ สกมช. สำหรับผู้บริหาร ทีมพัฒนาและปฏิบัติการ AI ฝ่ายกฎหมายและ DPO และฝ่ายความมั่นคงปลอดภัย โดยเรียงตามวงจรชีวิตของระบบและหลักธรรมาภิบาลความเสี่ยง
- กลุ่มเป้าหมายที่บังคับใช้
- ผู้บริหาร ทีมพัฒนาและปฏิบัติการ AI ฝ่ายกฎหมายและ DPO และฝ่ายความมั่นคงปลอดภัยตามแนวปฏิบัติของ สกมช.
- ความถี่ในการทดสอบ
- ครอบคลุมตลอดวงจรชีวิต AI (ระยะที่ 0 ถึง 6 ตั้งแต่ขั้นตอนแนวคิดจนถึงการกำจัดและทำลาย)
- ขอบเขตการทดสอบ
- Prompt, โมเดล, API, ข้อมูลฝึกสอน, ห่วงโซ่อุปทานซอฟต์แวร์ และซอฟต์แวร์แวดล้อม
- ความเสี่ยงหากไม่ปฏิบัติตาม
- Prompt Injection, Jailbreaking, Data Poisoning, ข้อมูลความลับรั่วไหล และการเปิดใช้งานโดยไม่มีหลักฐานทวนสอบ
วัตถุประสงค์และกลุ่มผู้อ่าน
เอกสารจัดทำโดย สกมช. เพื่อเป็นแนวทางในการพัฒนา บริหารจัดการ และใช้งานระบบ AI อย่างมั่นคงปลอดภัยและน่าเชื่อถือ
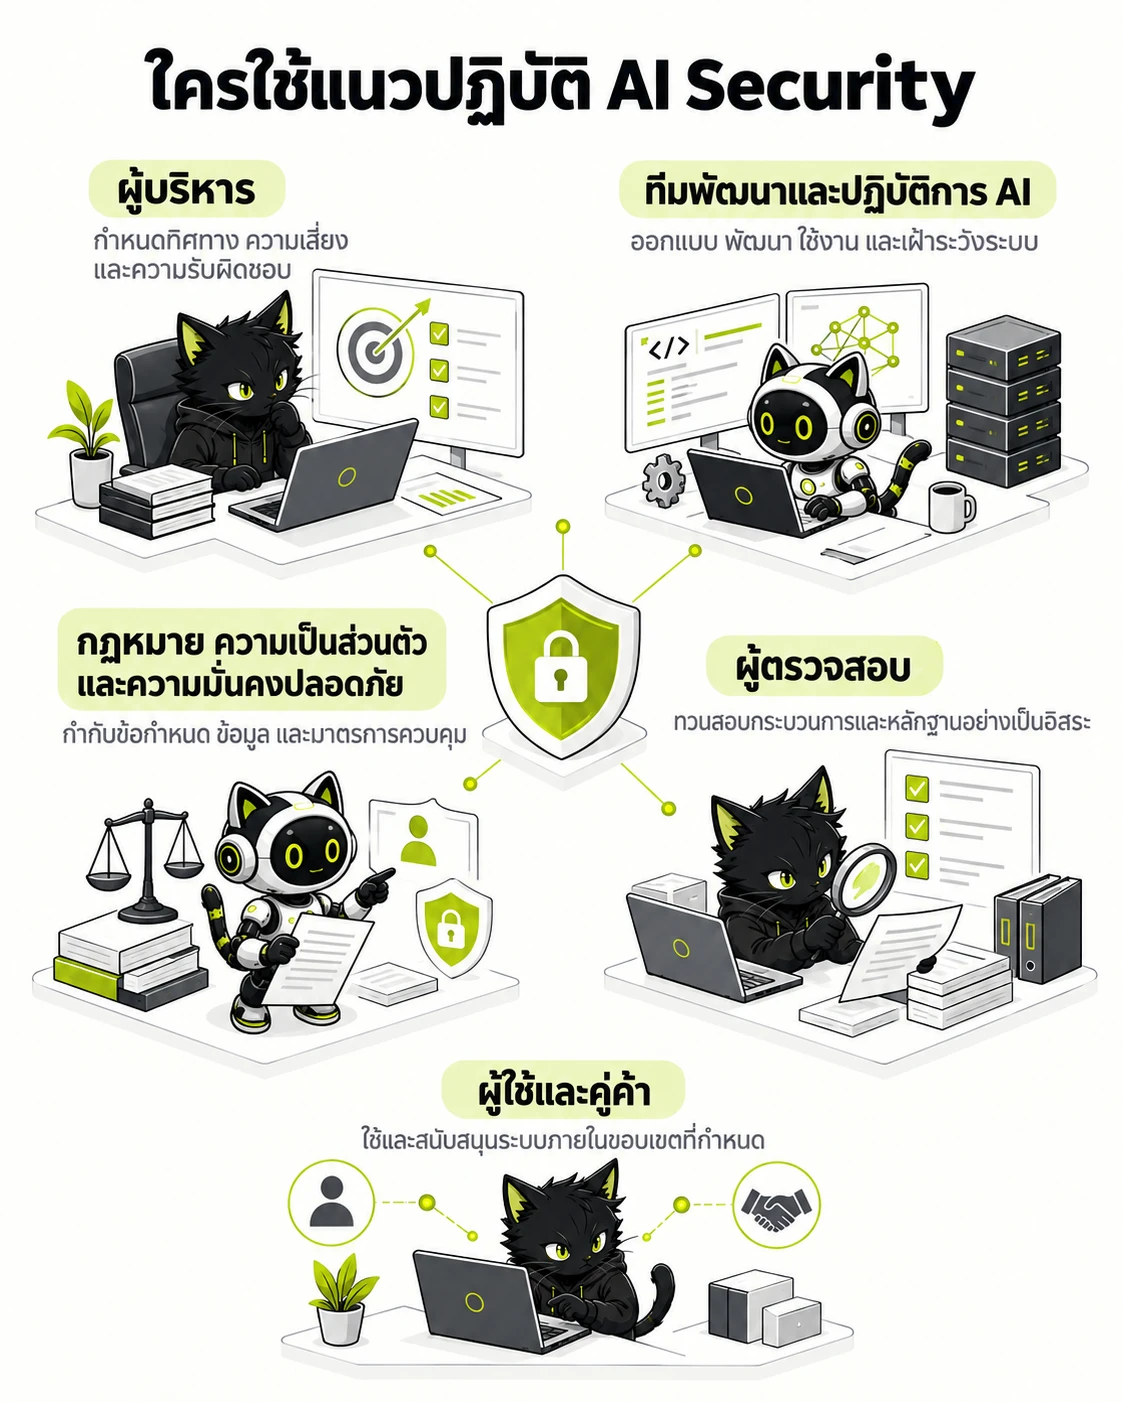
ทุกฝ่ายมีบทบาทต่างกัน แต่ต้องเชื่อมความเสี่ยง การควบคุม และหลักฐานตลอดวงจรชีวิต AI
- ผู้บริหาร — กำหนดทิศทาง ความเสี่ยง และความรับผิดชอบ
- ทีมพัฒนาและปฏิบัติการ AI — ออกแบบ พัฒนา ใช้งาน และเฝ้าระวังระบบ
- กฎหมาย ความเป็นส่วนตัว และความมั่นคงปลอดภัย — กำกับข้อกำหนด ข้อมูล และมาตรการควบคุม
- ผู้ตรวจสอบ — ทวนสอบกระบวนการและหลักฐานอย่างเป็นอิสระ
- ผู้ใช้และคู่ค้า — ใช้และสนับสนุนระบบภายในขอบเขตที่กำหนด
- ครอบคลุมมุมมองเชิงนโยบายสำหรับผู้บริหาร และมุมมองเชิงเทคนิคสำหรับทีมพัฒนาและปฏิบัติการ AI
- ระบุกลุ่มผู้เกี่ยวข้องตั้งแต่ฝ่ายกฎหมายและเจ้าหน้าที่คุ้มครองข้อมูลส่วนบุคคล ฝ่ายความมั่นคงปลอดภัย ผู้ใช้งาน ลูกค้า เจ้าของข้อมูล จนถึงผู้ขายในห่วงโซ่อุปทาน
- เอกสารอ้างอิงมาตรฐานและรายงานเชิงเทคนิคสากล เช่น ISO/IEC, ENISA และ OWASP ควบคู่กับกฎหมายและแนวปฏิบัติในประเทศไทย
วงจรชีวิต AI ที่เอกสารใช้เป็นโครงหลัก
แนวปฏิบัติจัดมาตรการความมั่นคงปลอดภัยให้ครอบคลุมตั้งแต่ก่อนลงทุนจนถึงการกำจัดข้อมูลและสินทรัพย์
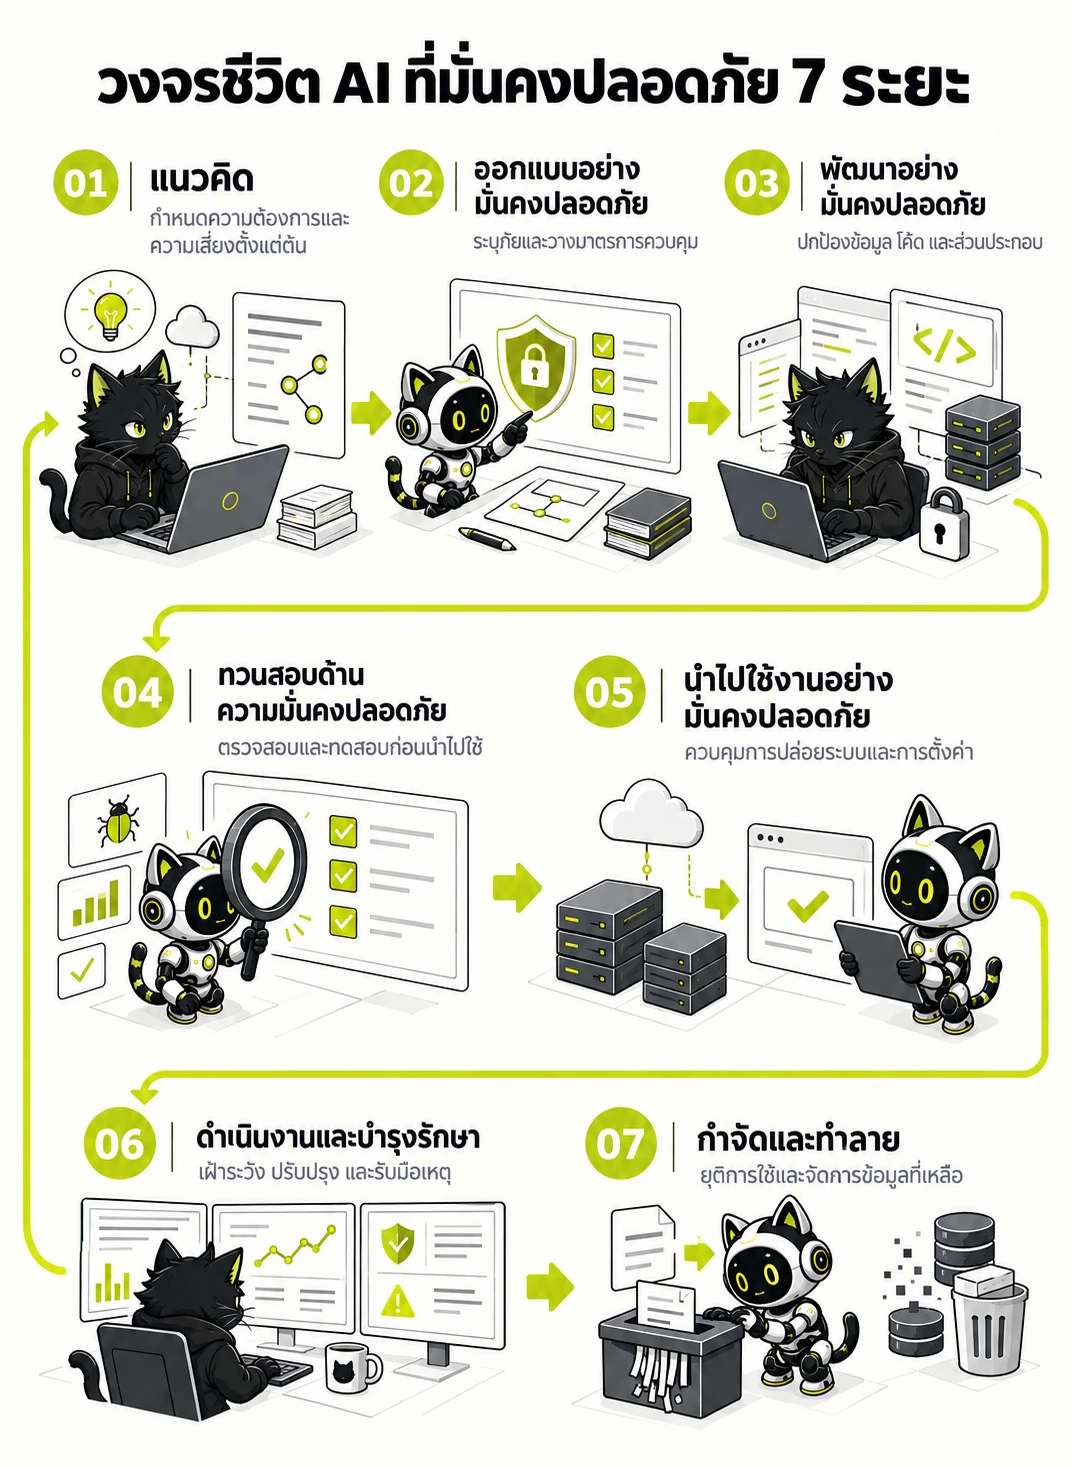
กำหนดเจ้าของงานและหลักฐานในแต่ละระยะ เพื่อให้ความมั่นคงปลอดภัยต่อเนื่องตั้งแต่แนวคิดจนเลิกใช้ระบบ
- แนวคิด — กำหนดความต้องการและความเสี่ยงตั้งแต่ต้น
- ออกแบบอย่างมั่นคงปลอดภัย — ระบุภัยและวางมาตรการควบคุม
- พัฒนาอย่างมั่นคงปลอดภัย — ปกป้องข้อมูล โค้ด และส่วนประกอบ
- ทวนสอบด้านความมั่นคงปลอดภัย — ตรวจสอบและทดสอบก่อนนำไปใช้
- นำไปใช้งานอย่างมั่นคงปลอดภัย — ควบคุมการปล่อยระบบและการตั้งค่า
- ดำเนินงานและบำรุงรักษา — เฝ้าระวัง ปรับปรุง และรับมือเหตุ
- กำจัดและทำลาย — ยุติการใช้และจัดการข้อมูลที่เหลือ
- ระยะที่ 0: แนวคิด - ระบุบริบทธุรกิจ กฎหมายและข้อบังคับ สินทรัพย์ ภัยคุกคาม ช่องโหว่ และความเสี่ยงก่อนเริ่มพัฒนา
- ระยะที่ 1-3: ออกแบบอย่างมั่นคงปลอดภัย พัฒนาอย่างมั่นคงปลอดภัย และทวนสอบด้านความมั่นคงปลอดภัย
- ระยะที่ 4-6: นำไปใช้งานอย่างมั่นคงปลอดภัย ดำเนินงานและบำรุงรักษาอย่างมั่นคงปลอดภัย และการปลดระวางพร้อมทำลายข้อมูลอย่างปลอดภัย (Decommissioning & Disposal)
ธรรมาภิบาล ความเสี่ยง และความรับผิดชอบ
บทการกำกับดูแลใช้กรอบ GRC (Governance, Risk Management and Compliance) และย้ำว่าความเสี่ยงต้องประเมินตามบริบทของระบบแต่ละองค์กร
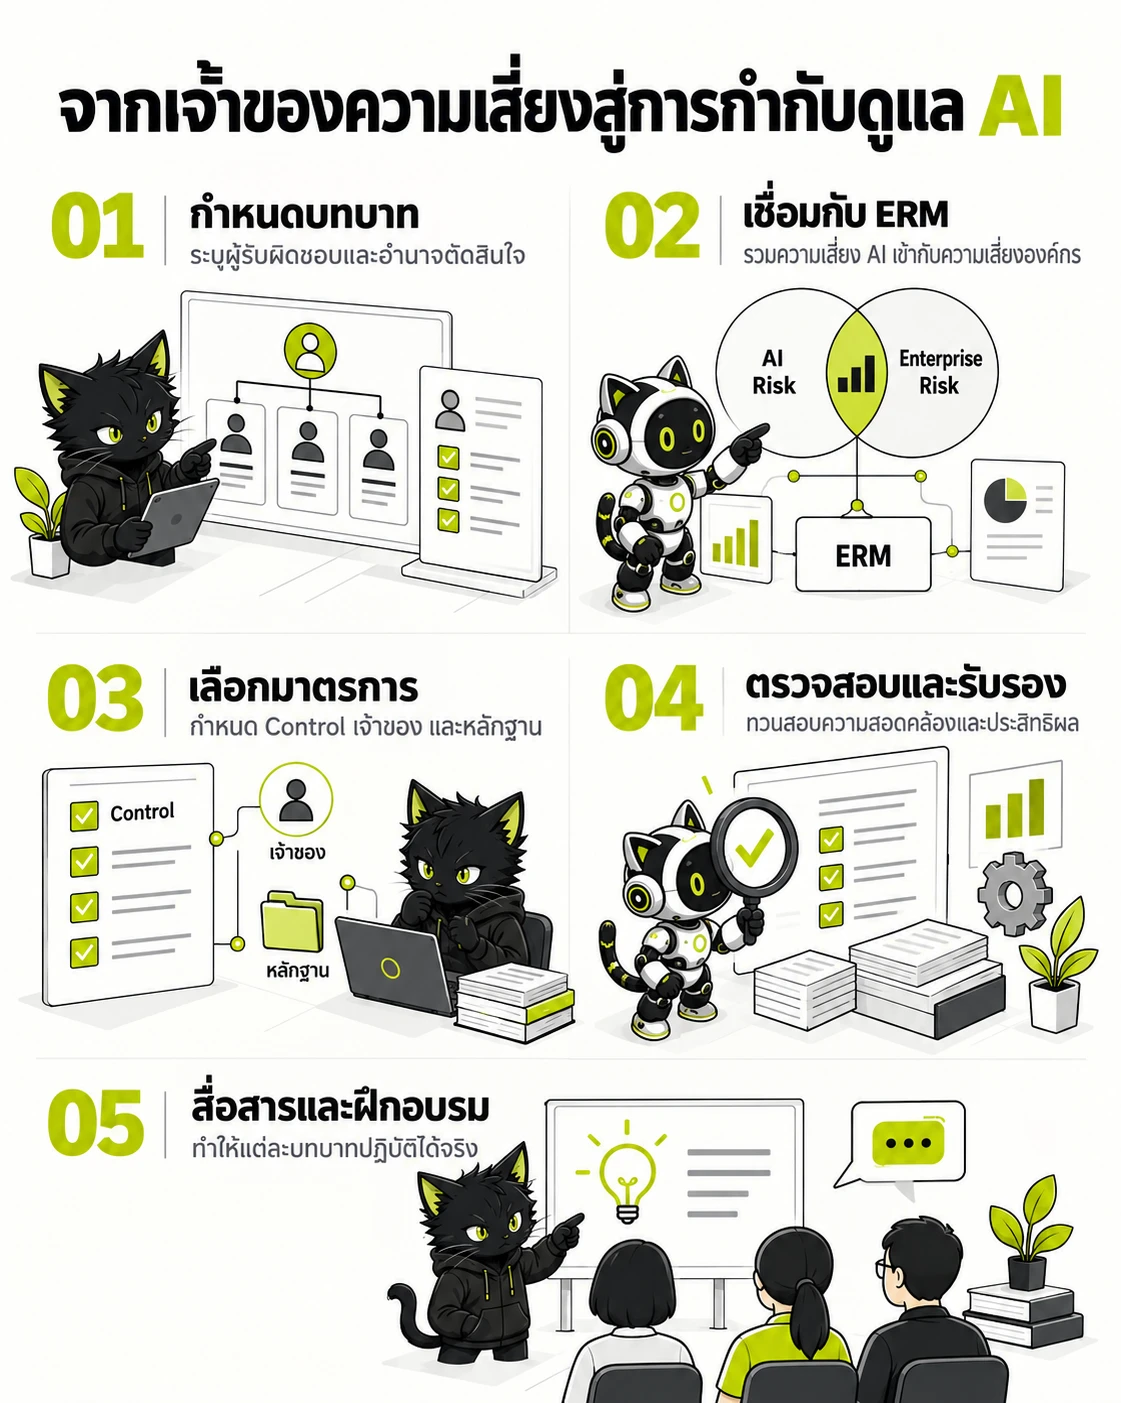
ความเสี่ยง AI ต้องมีเจ้าของ การตัดสินใจ หลักฐาน และการทบทวนที่ตรวจสอบได้
- กำหนดบทบาท — ระบุผู้รับผิดชอบและอำนาจตัดสินใจ
- เชื่อมกับ ERM — รวมความเสี่ยง AI เข้ากับความเสี่ยงองค์กร
- เลือกมาตรการ — กำหนด Control เจ้าของ และหลักฐาน
- ตรวจสอบและรับรอง — ทวนสอบความสอดคล้องและประสิทธิผล
- สื่อสารและฝึกอบรม — ทำให้แต่ละบทบาทปฏิบัติได้จริง
- กำหนดบทบาท อำนาจ และความรับผิดชอบด้านความมั่นคงปลอดภัยของระบบ AI เป็นลายลักษณ์อักษร
- บูรณาการความเสี่ยง AI เข้ากับกรอบบริหารความเสี่ยงขององค์กร และติดตามกฎหมายและข้อบังคับของไทยที่เกี่ยวข้อง
- วางการตรวจสอบ การรับรอง การสื่อสาร และการฝึกอบรมเพื่อให้ควบคุมและตรวจสอบการใช้งานได้
ข้อเสนอแนะสำหรับการปฏิบัติจริง
เอกสารแนะนำให้เตรียมมาตรการสำคัญเพื่อรองรับการตรวจสอบและการทบทวนย้อนหลัง
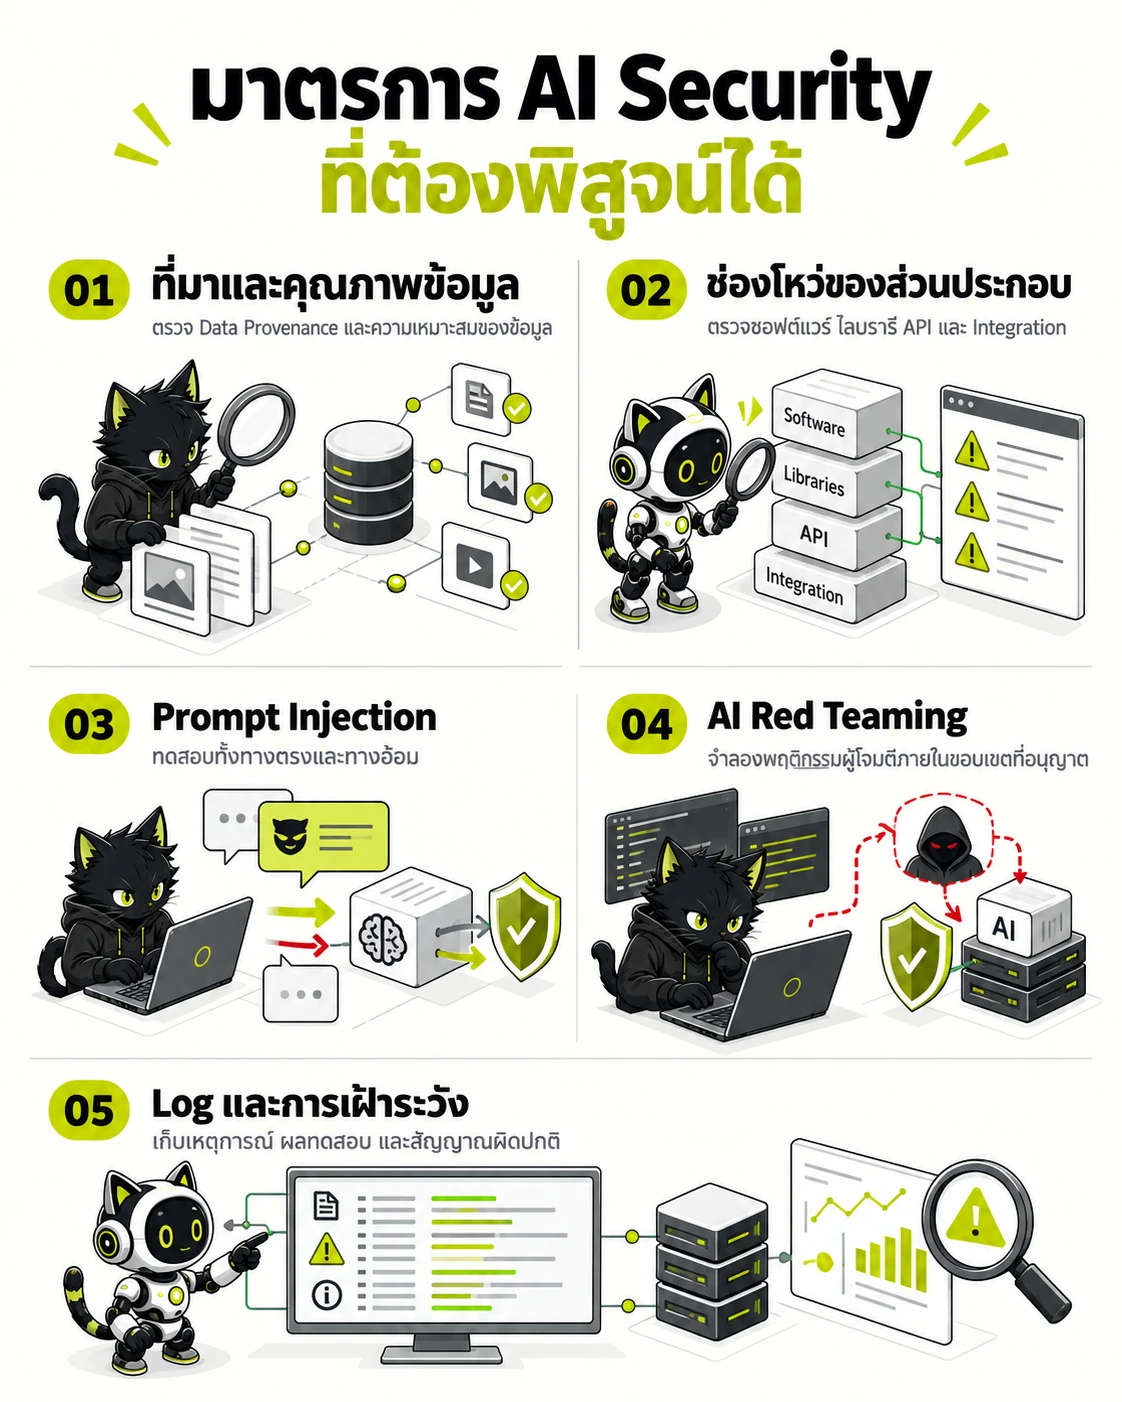
มาตรการที่เลือกต้องมีหลักฐานว่าทำงานกับระบบ AI จริง
- ที่มาและคุณภาพข้อมูล — ตรวจ Data Provenance และความเหมาะสมของข้อมูล
- ช่องโหว่ของส่วนประกอบ — ตรวจซอฟต์แวร์ ไลบรารี API และ Integration
- Prompt Injection — ทดสอบทั้งทางตรงและทางอ้อม
- AI Red Teaming — จำลองพฤติกรรมผู้โจมตีภายในขอบเขตที่อนุญาต
- Log และการเฝ้าระวัง — เก็บเหตุการณ์ ผลทดสอบ และสัญญาณผิดปกติ
- จัดทำ Data Provenance และสแกนช่องโหว่ซอฟต์แวร์ประมวลผลก่อนใช้งาน
- ทดสอบ Prompt Injection ทั้งแบบ Direct และ Indirect รวมถึง Jailbreaking ตามที่เอกสารระบุในระยะทวนสอบ
- ทำ AI Red Teaming และทดสอบเจาะระบบครอบคลุมโมเดล, API และซอฟต์แวร์แวดล้อมก่อนตัดสินใจเปิดใช้งาน
ตารางเปรียบเทียบข้อกำหนดและการทดสอบความปลอดภัย
สรุปรายละเอียดประกาศ บทบัญญัติ และขอบเขตการทดสอบความปลอดภัยที่จำเป็น
| ประกาศ และข้อกำหนด | สาระสำคัญ | ขอบเขตการทดสอบ | รอบเวลาทดสอบ |
|---|---|---|---|
| ระยะที่ 0 ถึง 3 (สกมช. AI) | ขั้นตอนแนวคิด การออกแบบ การพัฒนา และการทวนสอบอย่างมั่นคงปลอดภัย | Threat Model, ข้อมูลฝึกสอน, ห่วงโซ่อุปทานซอฟต์แวร์, Prompt Injection และ AI Red Teaming | ก่อนตัดสินใจลงทุน พัฒนา และเปิดใช้งาน |
| ระยะที่ 4 ถึง 6 (สกมช. AI) | การนำไปใช้งาน การดำเนินงานและการบำรุงรักษา และการกำจัดทำลาย | Secure Baseline, การเฝ้าระวัง Prompt, API และซอฟต์แวร์แวดล้อม | ก่อนเปิดใช้งาน และตลอดวงจรชีวิตจนถึงการกำจัดโมเดล |
เครื่องมือประเมินความพร้อม
คลิกเลือกรายการที่องค์กรของท่านได้ดำเนินการแล้ว เพื่อคำนวณระดับความพร้อมเบื้องต้น
STH AI SECURITY TESTING
Pentest สำหรับ LLM-integrated App และ AI Red Teaming
ระบบที่เชื่อม LLM มีพื้นผิวโจมตีมากกว่าโมเดลเพียงอย่างเดียว: ต้องพิจารณาแอปพลิเคชัน ช่องทางรับข้อมูล RAG หรือ Vector Store เครื่องมือที่ Agent เรียกใช้ สิทธิ์ ข้อมูล และการบันทึกเหตุการณ์ร่วมกัน
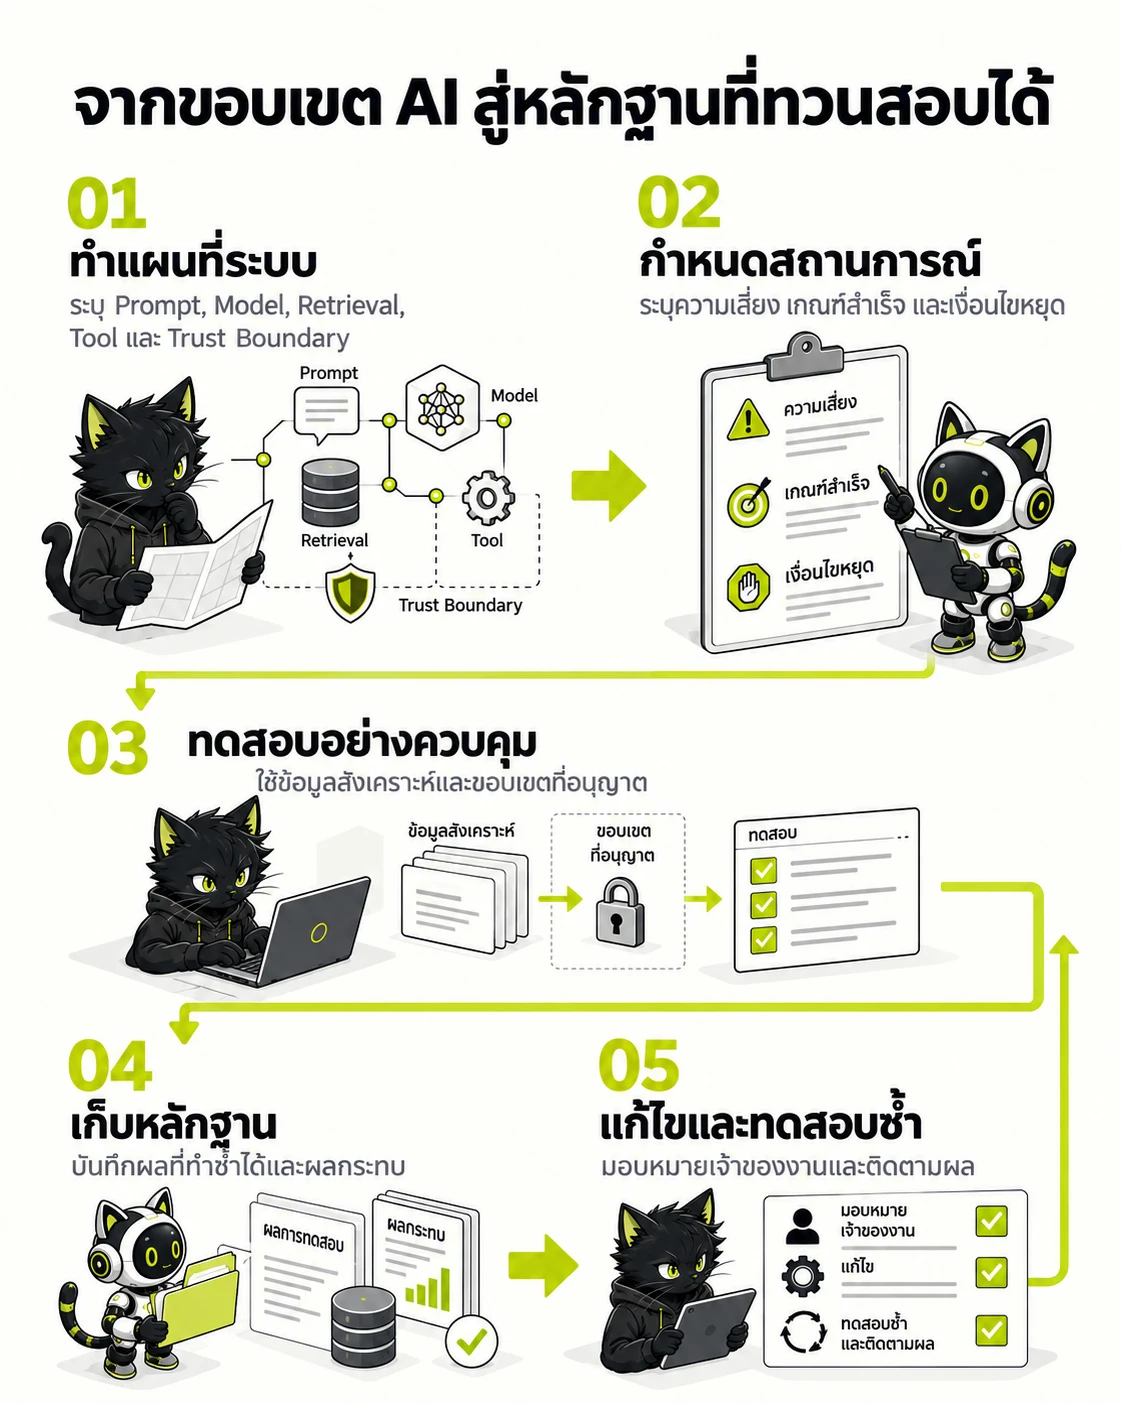
แยกขอบเขตการทดสอบแอปที่เชื่อม LLM ออกจากการจำลองภัยของ AI Red Teaming แล้วใช้หลักฐานตอบเป้าหมายของแต่ละงาน
- ทำแผนที่ระบบ — ระบุ Prompt, Model, Retrieval, Tool และ Trust Boundary
- กำหนดสถานการณ์ — ระบุความเสี่ยง เกณฑ์สำเร็จ และเงื่อนไขหยุด
- ทดสอบอย่างควบคุม — ใช้ข้อมูลสังเคราะห์และขอบเขตที่อนุญาต
- เก็บหลักฐาน — บันทึกผลที่ทำซ้ำได้และผลกระทบ
- แก้ไขและทดสอบซ้ำ — มอบหมายเจ้าของงานและติดตามผล
Pentest ระบบที่เชื่อม LLM
ทวนสอบการบังคับใช้ control ที่จุดเชื่อมต่อของระบบ โดยไม่จำกัดอยู่แค่พฤติกรรมของโมเดล
- สิทธิ์ผู้ใช้ การแยกข้อมูลระหว่างผู้ใช้หรือ Tenant และการเปิดเผยข้อมูลผ่านคำตอบหรือเอกสารที่ค้นคืน
- การเชื่อมต่อ RAG, Vector Store, Model Provider, API และเครื่องมือภายนอก รวมถึงขอบเขต Token และ Secret
- การอนุมัติและการบังคับใช้สิทธิ์ก่อน Agent เรียกใช้เครื่องมือหรือทำรายการที่มีผลกระทบ
AI Red Teaming
จำลองพฤติกรรมเชิงปฏิปักษ์ในขอบเขตที่อนุญาต เพื่อพิสูจน์ว่า guardrail และขั้นตอนป้องกันทำงานได้จริง
- Prompt Injection และ Indirect Prompt Injection จากข้อมูลหรือเอกสารที่ระบบนำไปใช้เป็นบริบท
- Jailbreak หรือความพยายามให้ระบบทำงานนอกวัตถุประสงค์ พร้อมทวนสอบการจัดการ output ที่ไม่ปลอดภัย
- ความเสี่ยงของ Agentic AI เมื่อคำสั่งหรือเครื่องมืออาจกระทบข้อมูล บัญชีผู้ใช้ หรือระบบปลายทาง
สิ่งที่ควรได้จากการทดสอบ
- ขอบเขตที่ได้รับอนุญาต สภาพแวดล้อมและข้อมูลทดสอบ เกณฑ์หยุดทดสอบ และผู้ประสานงานเหตุฉุกเฉิน
- หลักฐานผลการทดสอบ ระดับความรุนแรง เงื่อนไขการเกิดผลกระทบ และแนวทางแก้ไขที่ตรวจสอบซ้ำได้
- การทดสอบซ้ำหลังแก้ไข และรายการควบคุมหรือความเสี่ยงที่ต้องติดตามในการใช้งานจริง
แนวปฏิบัติ สกมช. ระยะที่ 3 Secure Verification ระบุการทดสอบเชิงรุก การทดสอบเจาะระบบ LLM สำหรับ Prompt Injection หรือ Jailbreaking ความเสี่ยงการรั่วไหลของข้อมูล และการทดสอบคำสั่งอันตรายของ Agent เป็นตัวอย่างหลักฐานการทวนสอบก่อนนำไปใช้งาน
ปรึกษา Pentest LLM-integrated App และ AI Red Teaming กับ STH
คำถามที่พบบ่อย (FAQ)
คำถามและข้อสงสัยสำคัญเกี่ยวกับข้อกำหนดและการตรวจประเมินตามมาตรฐาน
แนวปฏิบัติ AI Security Guidelines ของ สกมช. ครอบคลุมระบบ AI ประเภทใดบ้าง?
ครอบคลุมทั้งระบบ AI ดั้งเดิม (Machine Learning) และระบบ Generative AI และ LLM ที่องค์กรนำมาประยุกต์ใช้ในบริการหรือกระบวนการทำงานภายใน
การทำ Pentest สำหรับระบบที่ใช้ LLM แตกต่างจากการทดสอบเว็บหรือแอปทั่วไปอย่างไร?
นอกจากจุดเชื่อมต่อเว็บและ API ปกติแล้ว เอกสารให้ทวนสอบความเสี่ยงเฉพาะของ AI เช่น Prompt Injection, Jailbreaking และ AI Red Teaming ครอบคลุมโมเดล, API และซอฟต์แวร์แวดล้อม
