
AI Red Teaming: กรอบการทดสอบโมเดล AI, Agent และ RAG เชิงรุกตามมาตรฐานสากล
คู่มือการทดสอบความมั่นคงปลอดภัยระบบ AI เชิงรุกอ้างอิง OWASP GenAI Red Teaming Manual v1.0 (ตุลาคม 2026) ครอบคลุม 6 ระยะวงจรชีวิต GenAI 3 รูปแบบการเข้าถึง ระเบียบวิธี 8 ขั้นตอน เกณฑ์คัดเลือกผู้ให้บริการ 13 ด้าน การวิเคราะห์ภัยคุกคาม Multi-Agent ด้วย MAESTRO 7 ชั้น ความมั่นคงปลอดภัย MCP และเชื่อมโยงเชิงเทียบเคียงกับ NIST AI 100-2e2025 (มีนาคม 2025 ฉบับสมบูรณ์), NIST AI 600-1 (MS-2.7-007), Google SAIF 2.0 (Assurance: Red Teaming และ SAIF Focus on Agents) รวมถึงแนวทางกำกับของไทย
- กลุ่มเป้าหมาย
- ทีมวิศวกรรมความมั่นคงปลอดภัย ผู้พัฒนาโมเดล AI และองค์กรที่ใช้งาน RAG, LLM Application หรือ Autonomous Agent
- รอบการทดสอบและทบทวน
- ก่อนเปิดใช้งานระบบสู่ Production และสม่ำเสมอเมื่อมีการอัปเดตโมเดล ชุดข้อมูล RAG หรือสิทธิ์การทำงานของ Agent ตามข้อเสนอแนะของ STH
- ขอบเขตการทดสอบ
- Model Evaluation, Guardrail Verification, RAG และ Vector Database, Autonomous Agent Workflow และการเชื่อมต่อ MCP Server ตาม OWASP Manual v1.0, NIST AI 100-2e2025 และ Google SAIF 2.0
- ความเสี่ยงที่เกี่ยวข้อง
- Prompt Injection, การวางยาข้อมูล (Data Poisoning), การรั่วไหลของข้อมูลผ่านโมเดล, Rogue Action และการถูกยึดครองระบบ Agent
ขอบเขตการทดสอบ 4 ชั้นสถาปัตยกรรมที่สังเคราะห์จาก OWASP GenAI Red Teaming Manual
OWASP GenAI Red Teaming Manual v1.0 (ตุลาคม 2026) วางกรอบการทดสอบตาม 6 ระยะวงจรชีวิต 3 ระดับการเข้าถึง (Black-box, Gray-box และ White-box) และหมวดภัยคุกคามทางเทคนิค (หัวข้อ 4.2 ถึง 4.7) ซึ่งสามารถจัดกลุ่มเชิงสถาปัตยกรรมออกเป็น 4 ชั้นเป้าหมาย พร้อมเทียบเคียงกับ NIST และ Google SAIF ดังนี้
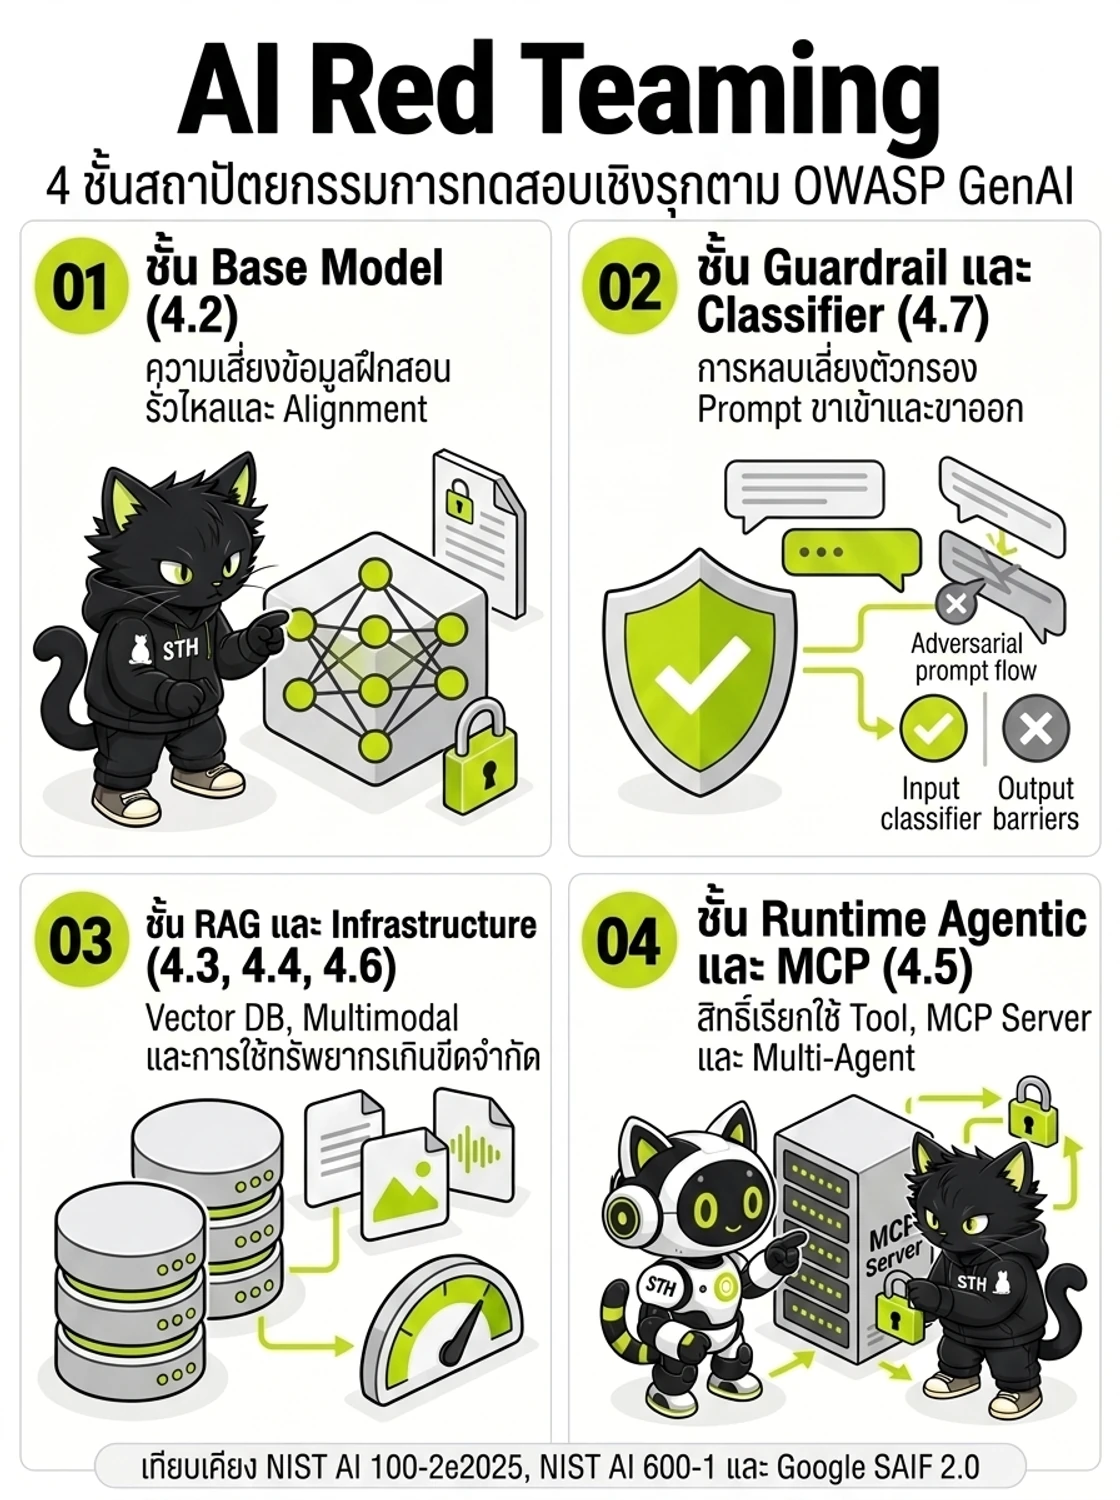
AI Red Teaming ตาม OWASP GenAI Red Teaming Manual v1.0 ครอบคลุมตั้งแต่ตัวโมเดลจนถึง Guardrail, RAG และ MCP
- ชั้น Base Model (4.2)
ทดสอบความเสี่ยงข้อมูลฝึกสอนรั่วไหลและความแข็งแกร่งของ Alignment - ชั้น Guardrail และ Classifier (4.7)
ทดสอบตัวกรองอินพุตกับเอาต์พุตและ Safety Classifier ต่อการหลบเลี่ยง - ชั้น RAG และ Infrastructure (4.3, 4.4, 4.6)
ประเมินฐานข้อมูลเวกเตอร์ อินพุตหลายรูปแบบ และการใช้ทรัพยากรเกินขีดจำกัด - ชั้น Runtime Agentic และ MCP (4.5)
ทดสอบสิทธิ์เรียกใช้ Tool ความปลอดภัย MCP Server และระบบ Multi-Agent
- ชั้น Base Model (Direct AI Vulnerabilities 4.2 และระยะ Model Selection) ทดสอบพฤติกรรมโมเดลพื้นฐาน ความเสี่ยงการรั่วไหลจากข้อมูลฝึกสอน การเสื่อมสภาพของ Alignment และ Adversarial Robustness
- ชั้น Guardrail และ Classifier (Guardrail & Safety-Classifier Evasion 4.7) ทดสอบตัวคัดกรองความปลอดภัย (Safety Classifier) ตัวกรอง Prompt และการหลบเลี่ยง Guardrail ทั้งขาเข้าและขาออก
- ชั้น RAG และ Infrastructure (AI Pathway Vulnerabilities 4.3, Multimodal 4.4 และ Resource Exhaustion DoW กับ DoS 4.6) ประเมินท่อส่งข้อมูล Retrieval-Augmented Generation, Vector Database, Middleware และช่องทางข้อมูลหลายรูปแบบ
- ชั้น Runtime Agentic และ Ecosystem (Agentic System Attack Vectors 4.5 และระยะ Deployment กับ Continuous Improvement) ทดสอบการตัดสินใจของ Agent สิทธิ์เรียกใช้ Tool เซิร์ฟเวอร์ Model Context Protocol (MCP) และการทำงานร่วมกันระหว่างหลาย Agent
- การเทียบเคียงเชิงปฏิบัติการกับอนุกรมวิธาน NIST และมาตรการ Google SAIF ช่วยเชื่อมขอบเขตการโจมตีเข้ากับ NIST AI 100-2e2025 (ฉบับสมบูรณ์ มีนาคม 2025) ซึ่งจำแนกการโจมตีทั้ง Predictive AI (Evasion, Poisoning และ Privacy) และ Generative AI (Supply-Chain Compromise, Direct และ Indirect Prompt Injection ตลอดจนความมั่นคงปลอดภัยของ Agent) ควบคู่กับการวัดผลตาม NIST AI 600-1 (MS-2.7-007) และหมวดมาตรการ Assurance (Red Teaming) กับ SAIF Focus on Agents ของ Google SAIF 2.0 ที่มุ่งป้องกัน Sensitive Data Disclosure และ Rogue Action โดยเป็นการเทียบเคียงเชิงเทคนิคเพื่อกำหนดขอบเขตการทดสอบ ไม่ใช่ตารางเชื่อมโยงอย่างเป็นทางการระหว่างหน่วยงาน
ระเบียบวิธีทดสอบ 8 ขั้นตอนสำหรับ AI Red Teaming
การทดสอบเจาะระบบ AI ต้องดำเนินตามขั้นตอนที่เป็นระบบและทำซ้ำได้ ตั้งแต่การวางแผนจนถึงการสร้าง Regression Test เพื่อป้องกันช่องโหว่เดิมกลับมา
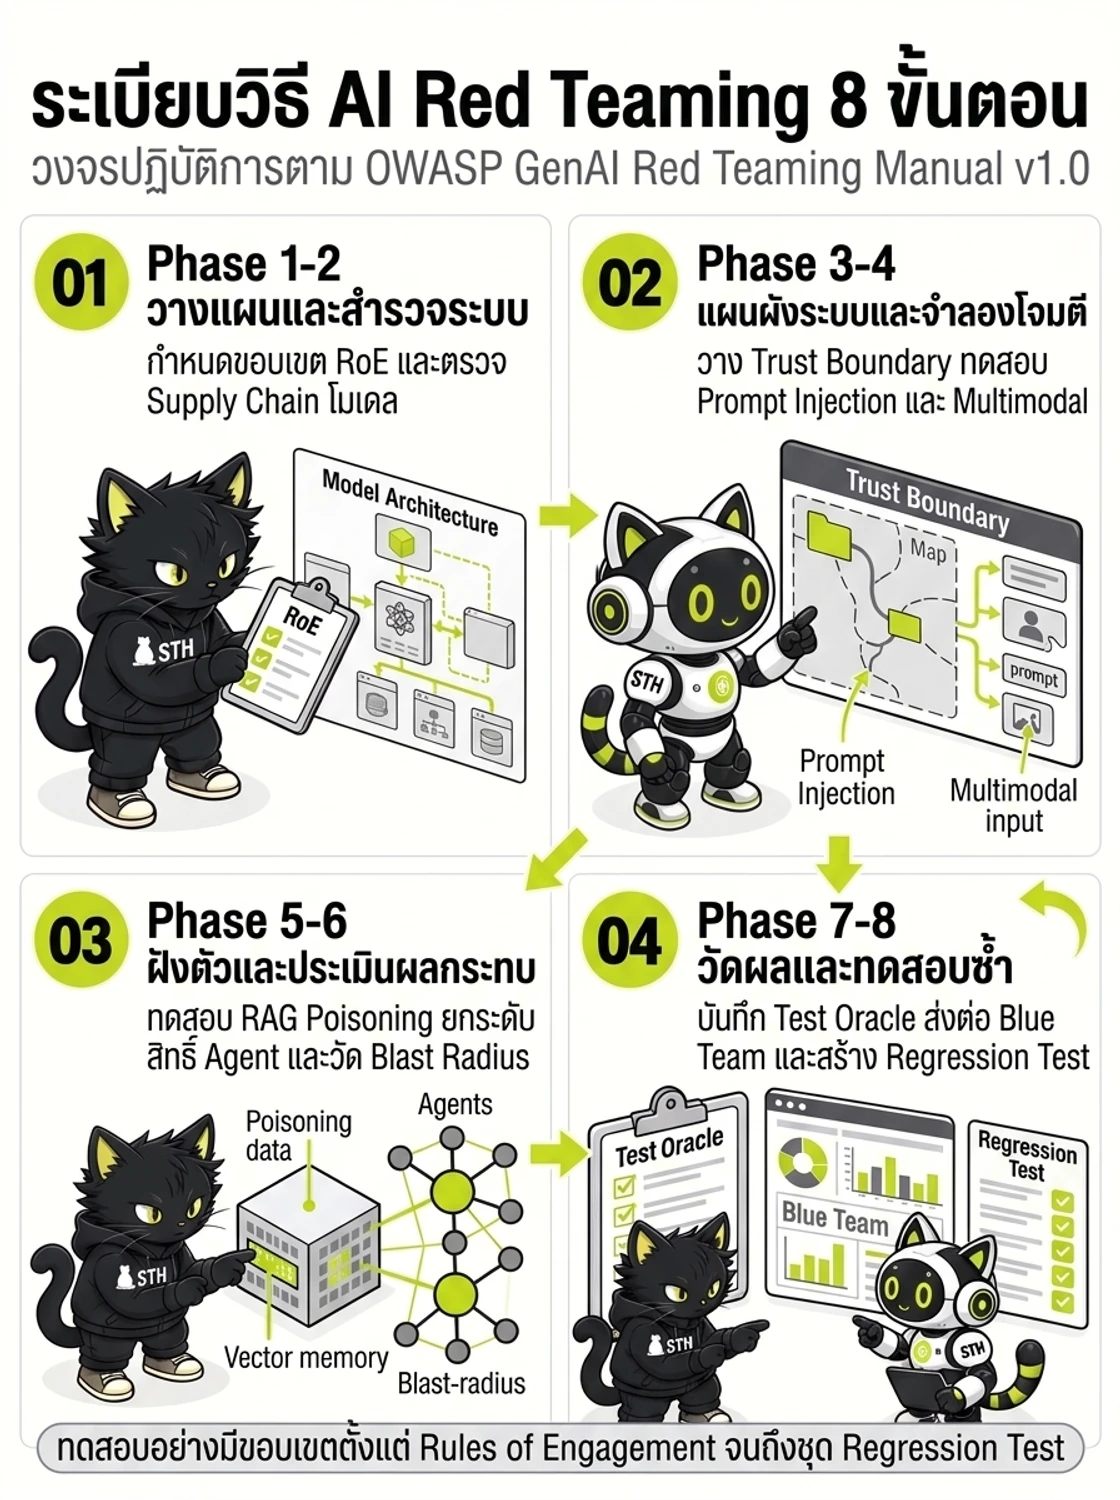
การทดสอบเชิงรุกที่วัดผลได้ต้องเริ่มจาก Rules of Engagement และจบด้วยเกณฑ์ตัดสินและ Regression Test ที่ทำซ้ำได้
- Phase 1 ถึง 2 วางแผนและสำรวจระบบ
กำหนดกฎ RoE ระดับการเข้าถึง และตรวจ Supply Chain ของโมเดล - Phase 3 ถึง 4 แผนผังระบบและจำลองโจมตี
วาง Trust Boundary ทดสอบ Prompt Injection และอินพุตหลายรูปแบบ - Phase 5 ถึง 6 ฝังตัวและประเมินผลกระทบ
ทดสอบ RAG Poisoning ยกระดับสิทธิ์ Tool และวัดขนาด Blast Radius - Phase 7 ถึง 8 วัดผลและทดสอบซ้ำ
บันทึก Test Oracle ส่งต่อ Telemetry ให้ Blue Team และสร้าง Regression Test
- Phase 1 Planning and Scoping: กำหนดผู้เกี่ยวข้อง เลือกระดับการเข้าถึงระบบระหว่าง Black-box, Gray-box หรือ White-box และกำหนดกฎการปะทะ (Rules of Engagement) ร่วมกับทีม AI Governance
- Phase 2 Reconnaissance and Fingerprinting: ตรวจสอบข้อมูลสาธารณะ วิเคราะห์ Supply Chain และสถาปัตยกรรมของโมเดลและไลบรารีที่ใช้งาน
- Phase 3 Surface Mapping: วางแผน Trust Boundary การไหลของข้อมูล และทำ Threat Modeling ซ้อนทับบนสถาปัตยกรรมระบบ
- Phase 4 Exploitation and Impact: ทำการทดสอบโจมตีผ่าน Prompt Injection ช่องทางข้อมูลหลายรูปแบบ (Multimodal Surface) การหลบเลี่ยง Guardrail และการทำให้ทรัพยากรประมวลผลหมดเปลือง (Economic Denial of Sustainability)
- Phase 5 Persistence and Escalation: ทดสอบการฝังคำสั่งในหน่วยความจำระยะยาวหรือ Vector Database และการยกระดับสิทธิ์ของ Agent เพื่อเข้าถึงฟังก์ชันที่ไม่ได้รับอนุญาต
- Phase 6 Post-Exploitation: ประเมินขอบเขตความเสียหาย (Blast Radius) และผลกระทบต่อธุรกิจเมื่อระบบ AI ถูกควบคุม
- Phase 7 Evaluation and Reporting: สรุปผลการทดสอบด้วยเกณฑ์วัดที่ทำซ้ำได้ (Reproducibility Control) และจัดทำรายงานช่องโหว่ตามระดับความเสี่ยง
- Phase 8 Post-Engagement and Remediation: ประสานงานกับทีมป้องกัน (Blue Team) เพื่อนำ Finding ไปปรับปรุงระบบตรวจจับ และสร้างชุดทดสอบซ้ำ (Regression Test) ใน Pipeline
เกณฑ์การคัดเลือกผู้ให้บริการ AI Red Teaming สำหรับองค์กร
OWASP Vendor Evaluation Criteria for AI Red Teaming v1.0 (มกราคม 2026) เสนอเกณฑ์ประเมิน 13 ด้าน (หัวข้อ 3.1 ถึง 3.13) พร้อมสัญญาณ Green Flag และ Red Flag โดยแยกความต้องการระหว่าง Simple GenAI กับ Advanced GenAI
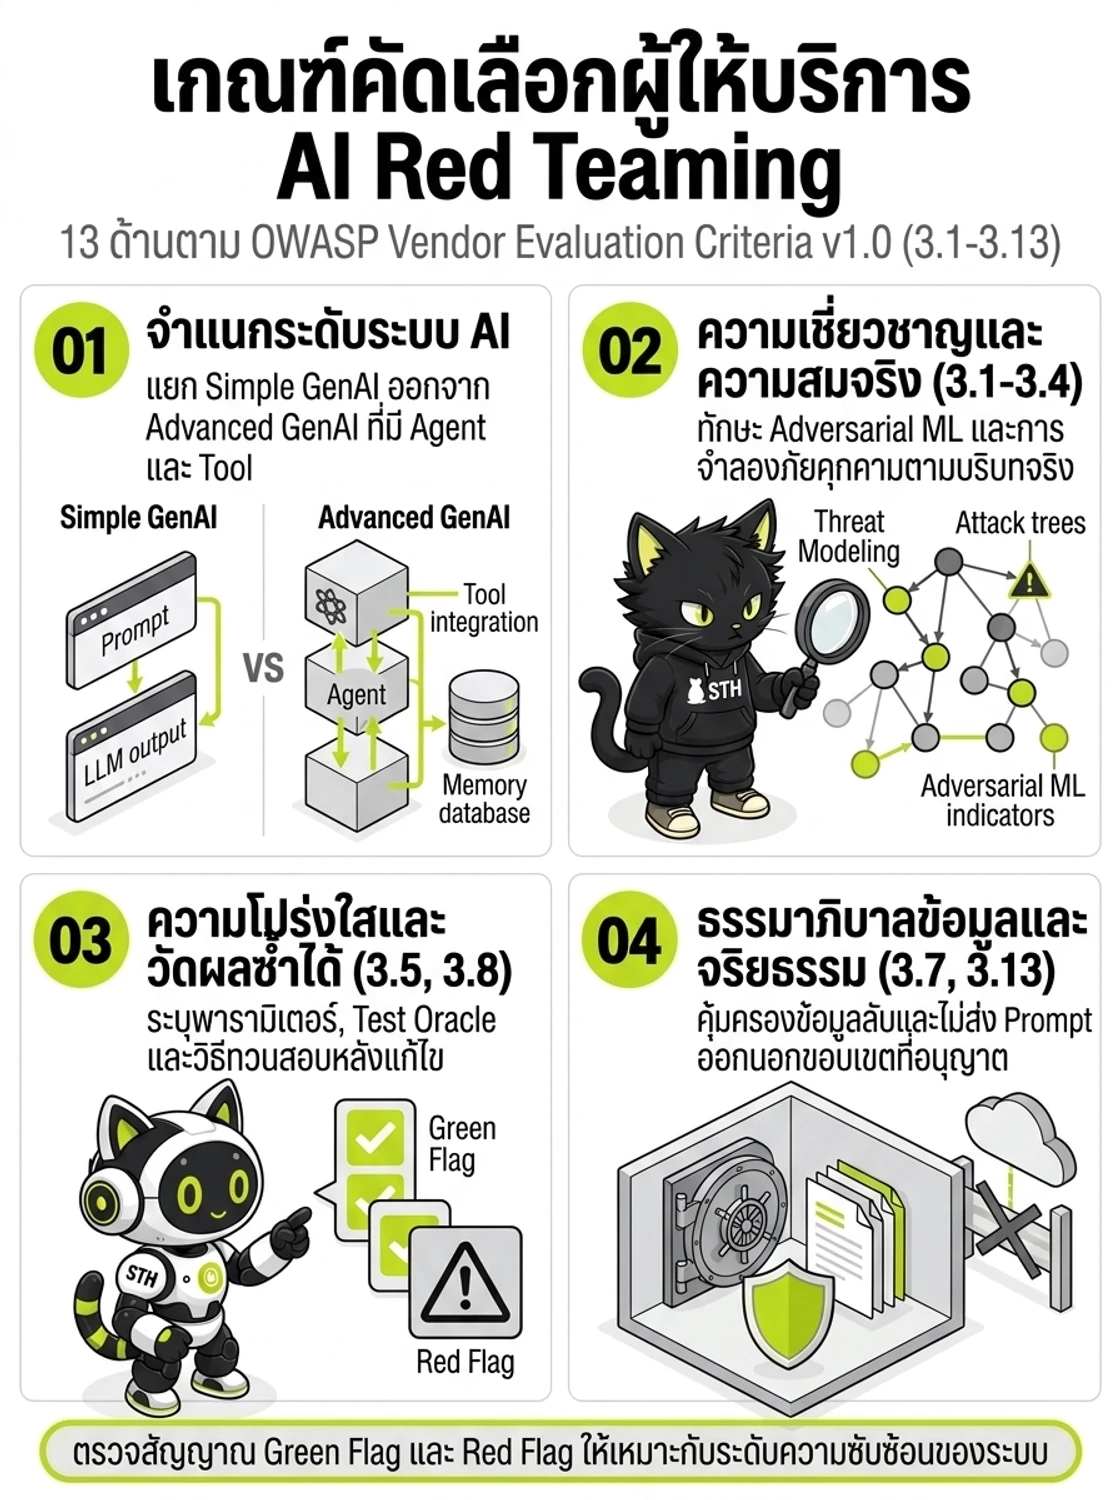
ตรวจสัญญาณ Green Flag และ Red Flag ทั้ง 13 ด้านให้สอดคล้องกับความซับซ้อนจริงของระบบ AI ในองค์กร
- จำแนกระดับระบบ AI
แยก Simple GenAI ออกจาก Advanced GenAI ที่มี Agent, Tool และ Memory - ความเชี่ยวชาญและความสมจริง (3.1 ถึง 3.4)
ประเมินทักษะ Adversarial ML และแบบจำลองภัยคุกคามเฉพาะบริบท - ความโปร่งใสและวัดผลซ้ำได้ (3.5, 3.8)
ระบุพารามิเตอร์, Test Oracle และวิธีทวนสอบหลังแก้ไขช่องโหว่ - ธรรมาภิบาลข้อมูลและจริยธรรม (3.7, 3.13)
คุ้มครอง Prompt ลับและป้องกันการส่งข้อมูลออกนอกขอบเขตที่อนุญาต
- แยกความซับซ้อนของระบบระหว่าง Simple GenAI System ที่โต้ตอบแบบ Prompt-Response เดี่ยว ออกจาก Advanced GenAI System ที่มี Agent Workflow การเรียกใช้ Tool หน่วยความจำ และระบบภายนอก
- เกณฑ์ด้าน Technical Competence (3.1) และ Methodology and Coverage (3.2) ประเมินความเชี่ยวชาญด้าน Adversarial ML ความเข้าใจสถาปัตยกรรม LLM และ Agent และความครอบคลุมเชิงรุก
- เกณฑ์ด้าน Adversarial Creativity and Domain Expertise (3.3) และ Realism of Threat Modeling (3.4) วัดความสามารถสร้างแนวทางโจมตีใหม่ตามบริบทธุรกิจนอกเหนือจากสคริปต์สำเร็จรูป
- เกณฑ์ด้าน Evaluation Rigor and Metrics (3.5) และ Transparency and Explainability (3.8) กำหนดให้รายงานพารามิเตอร์, Test Oracle และวิธีทำซ้ำได้อย่างโปร่งใส
- เกณฑ์ด้าน Data Governance and Security (3.7) และ Legal, Ethical, and Compliance Posture (3.13) คุ้มครองข้อมูลลับในการทดสอบและจำกัดการส่ง Prompt ไปยังบริการภายนอกที่ไม่ได้รับอนุญาต
การวิเคราะห์ภัยคุกคามระบบ Multi-Agent ด้วย MAESTRO Framework และการควบคุมความปลอดภัย MCP
การทดสอบ Agent ผสานกรอบ MAESTRO 7 ชั้นจาก OWASP Multi-Agentic System Threat Modelling Guide v1.0 เข้ากับแนวทางพัฒนาและคัดกรอง MCP Server ของ OWASP
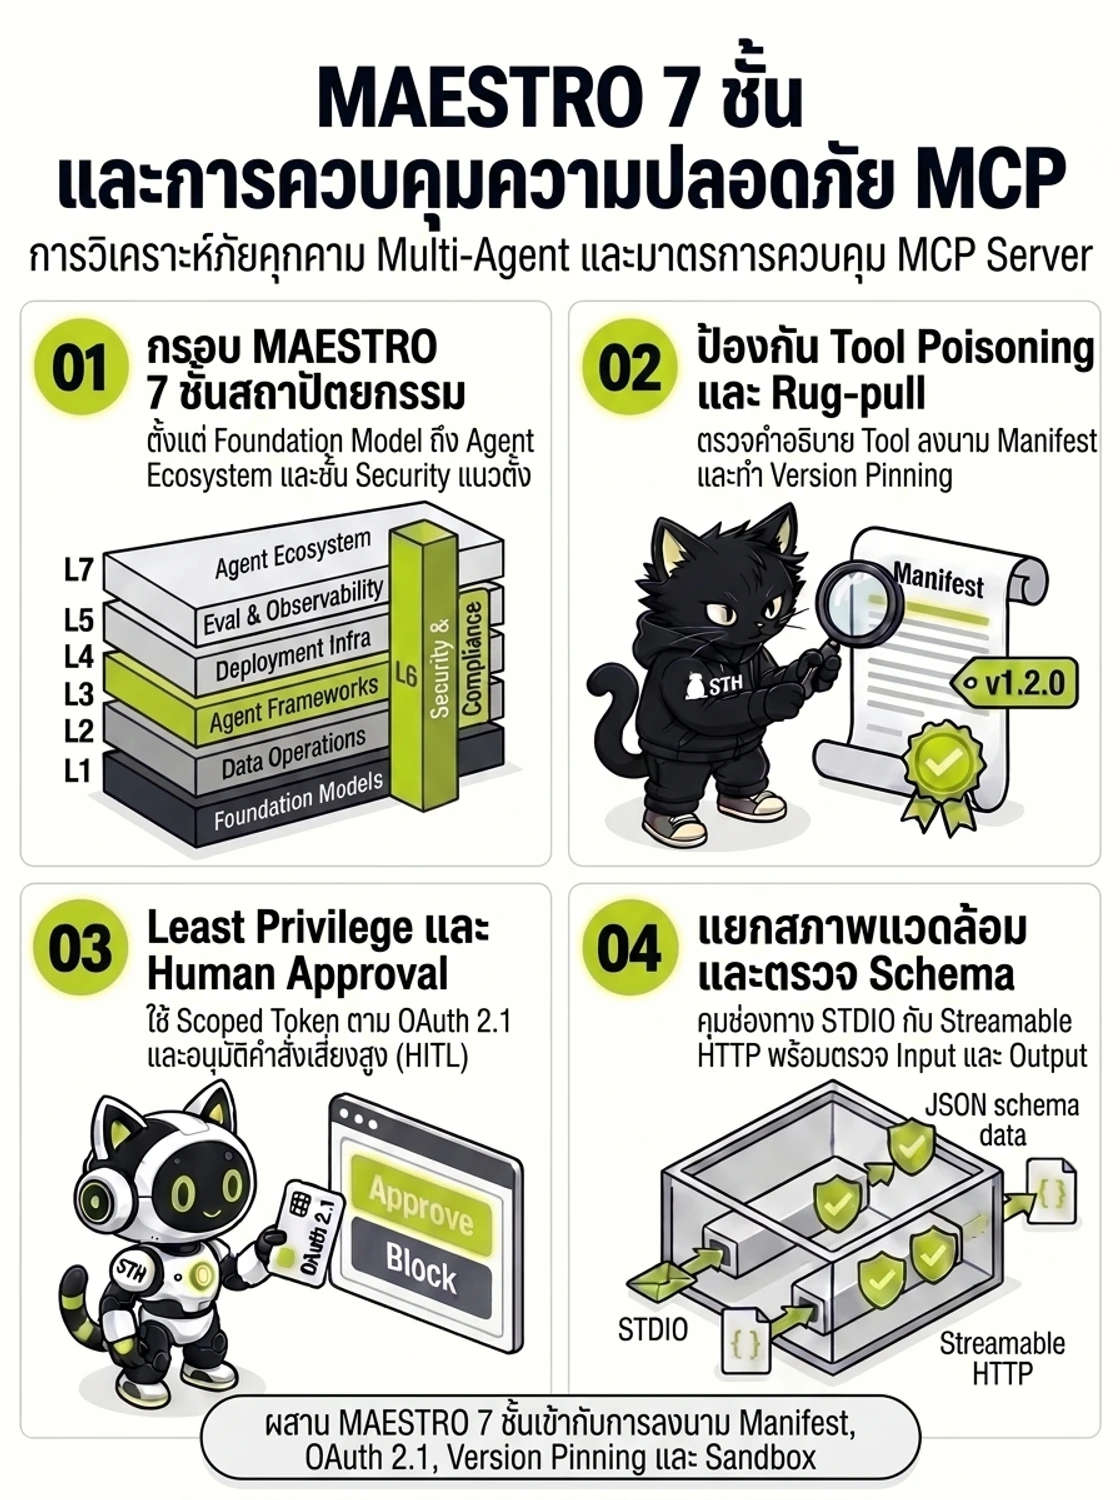
ผสาน MAESTRO 7 ชั้นเข้ากับการลงนาม Manifest, OAuth 2.1, Version Pinning และ Sandbox เพื่อลดความเสี่ยงของ MCP Server
- กรอบ MAESTRO 7 ชั้นสถาปัตยกรรม
ครอบคลุมตั้งแต่ Foundation Model จนถึง Agent Ecosystem พร้อมชั้น Security แนวตั้ง - ป้องกัน Tool Poisoning และ Rug-pull
ตรวจสอบคำอธิบาย Tool ลงนาม Manifest และทำ Version Pinning ก่อนใช้งาน - Least Privilege และ Human Approval
ใช้ Token อายุสั้นตาม OAuth 2.1 และกำหนดจุดอนุมัติคำสั่งเสี่ยงสูง - แยกสภาพแวดล้อมและตรวจ Schema
จำกัดขอบเขตช่องทาง STDIO กับ Streamable HTTP พร้อมตรวจโครงสร้างอินพุตและเอาต์พุต
- วิเคราะห์ภัยคุกคามครอบคลุม 7 ชั้นสถาปัตยกรรมของ MAESTRO ได้แก่ Foundation Models (Layer 1), Data Operations (Layer 2), Agent Frameworks (Layer 3), Deployment Infrastructure (Layer 4), Evaluation & Observability (Layer 5), Security and Compliance (Layer 6 แนวตั้ง) และ Agent Ecosystem (Layer 7)
- ป้องกัน Tool Poisoning โดยทดสอบคำอธิบาย Tool และ Metadata ที่อาจซ่อน Prompt Injection พร้อมลงนาม Cryptographic Tool Manifest และตรวจเทียบพฤติกรรมจริงกับคำอธิบายที่ประกาศ
- จำกัดสิทธิ์การทำงานของ Agent ตามหลัก Least Privilege ด้วย Scoped Short-Lived Token (OAuth 2.1 หรือ OIDC), นโยบายรวมศูนย์ (เช่น Policy-as-Code) และการอนุมัติโดยมนุษย์ (HITL) สำหรับคำสั่งเสี่ยงสูง
- ป้องกันการเปลี่ยนพฤติกรรมหรือเปลี่ยนโค้ด Tool ภายหลังอนุมัติ (Rug-pull Attack) ด้วย Version Pinning และการตรวจสอบ Hash หรือ Checksum ของ Manifest พร้อมคัดกรอง Third-party MCP Server
- บังคับใช้การแยกสภาพแวดล้อม (Sandboxing) และความปลอดภัยของช่องทางสื่อสาร MCP ทั้งช่องทางภายในอย่าง STDIO หรือ Unix Socket และช่องทางระยะไกลอย่าง Streamable HTTP รวมถึงการ Validate Schema ของ Input และ Output ทุกครั้ง
การปรับใช้ AI Red Teaming กับแนวทางกำกับดูแลของไทย
หน่วยงานกำกับดูแลของไทยได้ออกแนวปฏิบัติเชิงหลักการและแนวนโยบาย AI ซึ่งองค์กรสามารถใช้หลักฐานจาก AI Red Teaming สนับสนุนการประเมินความเสี่ยงตามสัดส่วนความสำคัญของระบบ
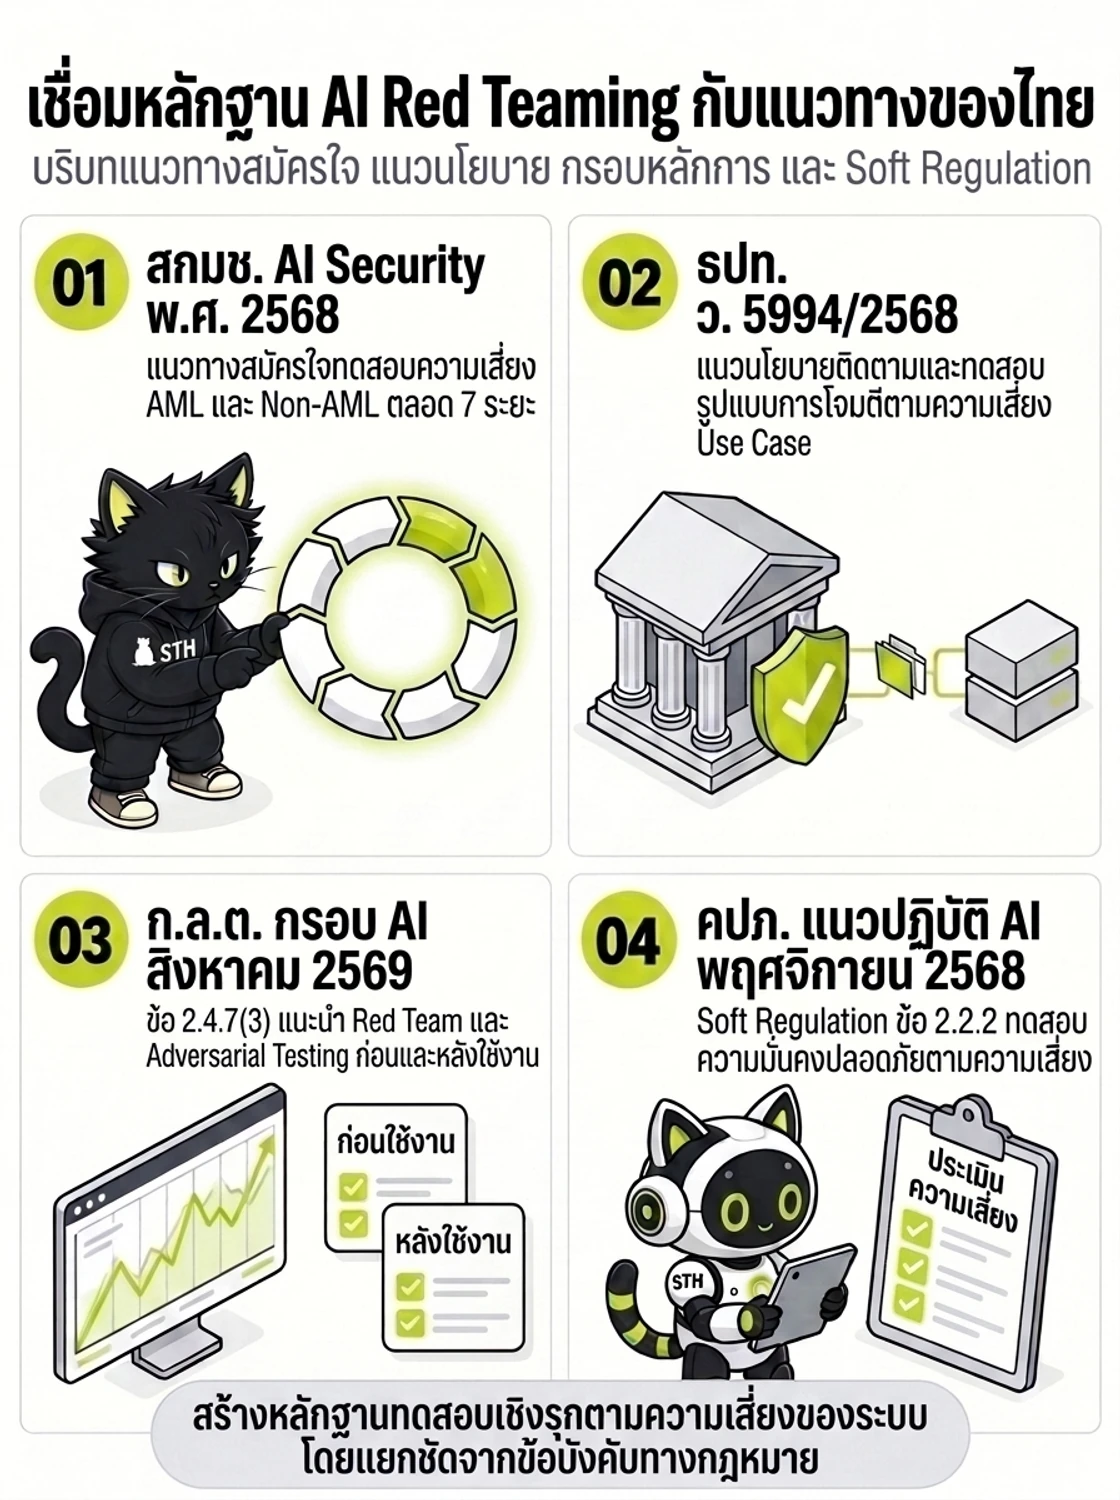
AI Red Teaming ช่วยสร้างหลักฐานเชิงเทคนิคสนับสนุนการประเมินความเสี่ยงตามแนวทางสมัครใจและแนวนโยบายของไทย ซึ่งแยกต่างหากจากข้อบังคับตามกฎหมาย
- สกมช. AI Security พ.ศ. 2568
แนวทางสมัครใจทดสอบความเสี่ยง AML และ Non-AML ตลอดวงจรชีวิต 7 ระยะ - ธปท. ว. 5994/2568
แนวนโยบายติดตามและทดสอบรูปแบบการโจมตีตามความเสี่ยงของ Use Case - ก.ล.ต. กรอบ AI สิงหาคม 2569
ข้อ 2.4.7(3) แนะนำ Red Team และ Adversarial Testing ทั้งก่อนและหลังใช้งาน - คปภ. แนวปฏิบัติ AI พฤศจิกายน 2568
Soft Regulation ข้อ 2.2.2 แนะนำการประเมินความทนทานและช่องโหว่ตามความเสี่ยง
- แนวปฏิบัติ AI Security Guidelines พ.ศ. 2568 ของ สกมช. (แนวทางสมัครใจ): ใช้ทดสอบความทนทานต่อการโจมตีตลอดวงจรชีวิต AI ทั้งหมวด Adversarial Machine Learning และความเสี่ยง Non-AML
- แนวนโยบายการบริหารจัดการความเสี่ยงระบบ AI ของ ธปท. (ว. 5994/2568): สถาบันการเงินและผู้ให้บริการชำระเงินสามารถประยุกต์ใช้ AI Red Teaming ในการติดตามและทดสอบรูปแบบการโจมตีอย่างเหมาะสมกับ Use Case
- กรอบการกำกับดูแล AI ในภาคตลาดทุนของ ก.ล.ต. (สิงหาคม 2569, Guideline เชิงหลักการ): รองรับข้อ 2.4.7(3) เรื่องการทดสอบ Red Team และ Adversarial Testing ก่อนและหลังใช้งาน รวมถึงภาคผนวก 2 และตัวอย่าง AIMS Control ในภาคผนวก 5
- แนวปฏิบัติ AI ของ คปภ. (พฤศจิกายน 2568, Soft Regulation): ใช้เป็นแนวทางสนับสนุนข้อ 2.2.2 เรื่องการทดสอบความมั่นคงปลอดภัยและประเมินช่องโหว่ AI ตามความเหมาะสมกับระดับความเสี่ยง ควบคู่กับข้อ 2.2.1 และข้อ 2.2.7
ตารางอ้างอิงและขอบเขตการประเมิน
สรุปเอกสารอ้างอิง ขอบเขตการประเมิน และรอบทบทวนตามบริบทของแต่ละรายการ
| เอกสารอ้างอิง | สาระสำคัญ | ขอบเขตการทดสอบ | รอบเวลาทดสอบ |
|---|---|---|---|
| OWASP GenAI Red Teaming Manual v1.0 (ตุลาคม 2026) | การทดสอบ 4 ชั้นสถาปัตยกรรม (หัวข้อ 4.2 ถึง 4.7 และ 6 ระยะวงจรชีวิต) | ทดสอบ Base Model (Direct AI Vulnerabilities 4.2), Guardrail (4.7), RAG และ Infrastructure (4.3, 4.4, 4.6) และ Runtime Agentic และ MCP (4.5) | ก่อนเปิดใช้งานระบบสู่ Production และเมื่อมีการเปลี่ยนแปลงโมเดล ข้อมูล RAG หรือสถาปัตยกรรมสำคัญ |
| OWASP GenAI Red Teaming 8-Phase Methodology | ระเบียบวิธีทดสอบเชิงรุก 8 ขั้นตอน | ดำเนินกระบวนการตั้งแต่ Planning and Scoping (1.6 Black-box, Gray-box และ White-box), Reconnaissance, Surface Mapping, Exploitation, Persistence, Post-Exploitation, Reporting และ Remediation | ตามรอบการประเมินความเสี่ยงและรอบ Release สำคัญของระบบ AI |
| OWASP Vendor Evaluation Criteria v1.0 (มกราคม 2026) | เกณฑ์ประเมินการจัดซื้อบริการ AI Red Teaming | จำแนก Simple GenAI กับ Advanced GenAI และประเมินผู้ให้บริการตามเกณฑ์ 13 ด้าน (หัวข้อ 3.1 ถึง 3.13) พร้อมสัญญาณ Green Flag และ Red Flag | ในขั้นตอนการจัดซื้อจัดจ้างและการคัดเลือกผู้ให้บริการทดสอบภายนอก |
| OWASP Multi-Agentic System Threat Modeling (MAESTRO) และ MCP Security | การวิเคราะห์ภัยคุกคาม Multi-Agent และความปลอดภัย MCP | วิเคราะห์ภัยคุกคาม 7 ชั้นของ MAESTRO ป้องกัน Tool Poisoning และ Rug-pull ด้วย Version Pinning และ Checksum, Scoped OAuth 2.1, HITL และ Sandboxing ช่องทาง STDIO และ Streamable HTTP | ในขั้นตอนการออกแบบสถาปัตยกรรมระบบ Agent และก่อนเชื่อมต่อ Tool ภายนอก |
| NIST AI 100-2e2025, AI 600-1 MS-2.7-007 และ Google SAIF 2.0 | การเทียบอนุกรมวิธานการโจมตีและกรอบ SAIF Focus on Agents | จำแนกวิธีโจมตี Evasion, Poisoning, Privacy และ Abuse ตาม NIST AI 100-2e2025 ควบคู่การทดสอบข้อกำหนด MS-2.7-007 และ Agent Boundary ภายใต้ SAIF Focus on Agents | ก่อนปล่อยใช้งานและเมื่อสถาปัตยกรรมหรือสิทธิ์ของ Agent เปลี่ยนแปลง |
| แนวทางกำกับดูแลของไทย (สกมช., ธปท., ก.ล.ต., คปภ.) | การจัดทำหลักฐานสนับสนุนแนวทางกำกับดูแลในประเทศ | สนับสนุนแนวทางสมัครใจ สกมช., แนวนโยบาย ธปท. ว. 5994/2568, กรอบเชิงหลักการ ก.ล.ต. 2569 ข้อ 2.4.7(3) และแนวปฏิบัติ Soft Regulation คปภ. 2568 ข้อ 2.2.2 | ตามระดับความเสี่ยงของ Use Case และนโยบายทบทวนขององค์กร |
รายการติดตามการดำเนินงาน
เลือกรายการที่องค์กรดำเนินการแล้ว เปอร์เซ็นต์แสดงสัดส่วนรายการที่เลือกเท่านั้น ไม่ใช่ผลประเมินความปลอดภัยหรือการปฏิบัติตามข้อกำหนด
คำถามที่พบบ่อย (FAQ)
คำถามและข้อสงสัยสำคัญเกี่ยวกับข้อกำหนดและการตรวจประเมินตามมาตรฐาน
AI Red Teaming แตกต่างจากการทำ Pentest หรือการประเมินโมเดลทั่วไปอย่างไร?
การประเมินโมเดลทั่วไปมักวัดความแม่นยำ (Accuracy) หรือความเป็นพิษของคำตอบเดี่ยว ขณะที่ AI Red Teaming เป็นการจำลองผู้โจมตีที่มุ่งเจาะระบบตั้งแต่ระดับโมเดล ตัวคัดกรอง Guardrail สถาปัตยกรรม RAG ไปจนถึงการตัดสินใจของ Autonomous Agent เพื่อทดสอบการทะลุผ่านขอบเขตความปลอดภัย การเรียกใช้ Tool เกินสิทธิ์ และการรั่วไหลของข้อมูลในโลกจริง
OWASP GenAI Red Teaming Manual v1.0 แบ่งโครงสร้างการทดสอบอย่างไร?
เอกสารฉบับ Version 1.0 (ตุลาคม 2026) จัดโครงสร้างผ่าน 3 ระดับการเข้าถึง (Black-box, Gray-box, White-box), 6 ระยะวงจรชีวิต GenAI, ระเบียบวิธี 8 ขั้นตอน (Phase 1 ถึง Phase 8) และหมวดภัยคุกคามทางเทคนิคหัวข้อ 4.2 ถึง 4.7 ซึ่งครอบคลุมตั้งแต่ Direct AI Vulnerabilities, AI Pathways (RAG), Multimodal, Agentic Vectors, Resource Exhaustion และ Guardrail Evasion
การจัดซื้อบริการ AI Red Teaming ควรพิจารณาเกณฑ์ใดเป็นสำคัญ?
ตาม OWASP Vendor Evaluation Criteria v1.0 (มกราคม 2026) องค์กรควรจำแนกว่าระบบเป็น Simple GenAI หรือ Advanced GenAI และประเมินผู้ให้บริการครบทั้ง 13 เกณฑ์ (หัวข้อ 3.1 ถึง 3.13) พร้อมดู Green Flag และ Red Flag ทั้งด้าน Adversarial Machine Learning ความคิดสร้างสรรค์ในการโจมตี ความโปร่งใสที่ทำซ้ำได้ และการคุ้มครองความลับของข้อมูล
แนวทางกำกับดูแล AI ของไทยฉบับใดบ้างที่สอดคล้องกับหลักฐานจาก AI Red Teaming?
หลักฐานจาก AI Red Teaming สามารถนำไปสนับสนุนแนวปฏิบัติ AI Security Guidelines ของ สกมช., แนวนโยบาย ธปท. ว. 5994/2568, กรอบเชิงหลักการของ ก.ล.ต. (สิงหาคม 2569) ข้อ 2.4.7(3) เรื่อง Red Team และ Adversarial Testing รวมถึงแนวปฏิบัติลักษณะ Soft Regulation ของ คปภ. (พฤศจิกายน 2568) ข้อ 2.2.2 เรื่องการทดสอบความมั่นคงปลอดภัยและประเมินช่องโหว่ AI ตามระดับความเสี่ยง
OWASP GenAI Red Teaming เชื่อมโยงกับ NIST AI RMF, NIST AI 100-2e2025 และ Google SAIF 2.0 อย่างไร?
OWASP GenAI Red Teaming Manual v1.0 ให้ระเบียบวิธีทดสอบเชิงรุก 8 ขั้นตอนและรายการโจมตี 4 ชั้น ซึ่งองค์กรสามารถนำไปเทียบกับอนุกรมวิธานการโจมตีและมาตรการป้องกันของ NIST AI 100-2e2025 (Evasion, Poisoning, Privacy และ Abuse) สร้างหลักฐานตามข้อกำหนด MS-2.7-007 ของ NIST AI 600-1 และทวนสอบการควบคุมขอบเขตใน Google SAIF 2.0 (Assurance: Red Teaming และ SAIF Focus on Agents)