
วิศวกรรมความมั่นคงปลอดภัยใน AI-Native SDLC: ควบคุม AI Coding Agent ป้องกัน Context Poisoning และ Sandbox Evasion
คู่มือนี้อ้าง Anthropic AI-Native SDLC Playbook และเอกสารความปลอดภัยของเครื่องมือ AI Coding Agent เพื่อเสนอการควบคุมตามความเสี่ยง ไม่ใช่กฎหมายหรือการรับรองมาตรฐาน
- กลุ่มเป้าหมาย
- ทีมพัฒนาและผู้รับผิดชอบความมั่นคงปลอดภัยที่ใช้ AI Coding Agent โดยเลือกมาตรการให้เหมาะกับผลิตภัณฑ์และสภาพแวดล้อม
- รอบการทดสอบและทบทวน
- ตรวจพฤติกรรมและสิทธิ์เมื่อเริ่มใช้หรือเปลี่ยนเครื่องมือ เลือกการทดสอบและ Review ตามความเสี่ยงของแต่ละงาน เป็นข้อเสนอวิศวกรรมของ STH
- ขอบเขตการทดสอบ
- Permission, Approval, Hook, Sandbox, เครือข่าย Dependency และหลักฐานการเผยแพร่
- ความเสี่ยงที่เกี่ยวข้อง
- Context Poisoning การขโมย Credential คำสั่งเกินขอบเขต และ Dependency ที่ไม่น่าเชื่อถือ
AI-Native SDLC เป็นแนวทางวิศวกรรม ไม่ใช่มาตรฐานกำกับ
คู่มือนี้อ้าง Anthropic AI-Native SDLC Playbook และเอกสารความปลอดภัยของเครื่องมือ AI Coding Agent เพื่อเสนอการควบคุมตามความเสี่ยง ไม่ใช่กฎหมายหรือการรับรองมาตรฐาน
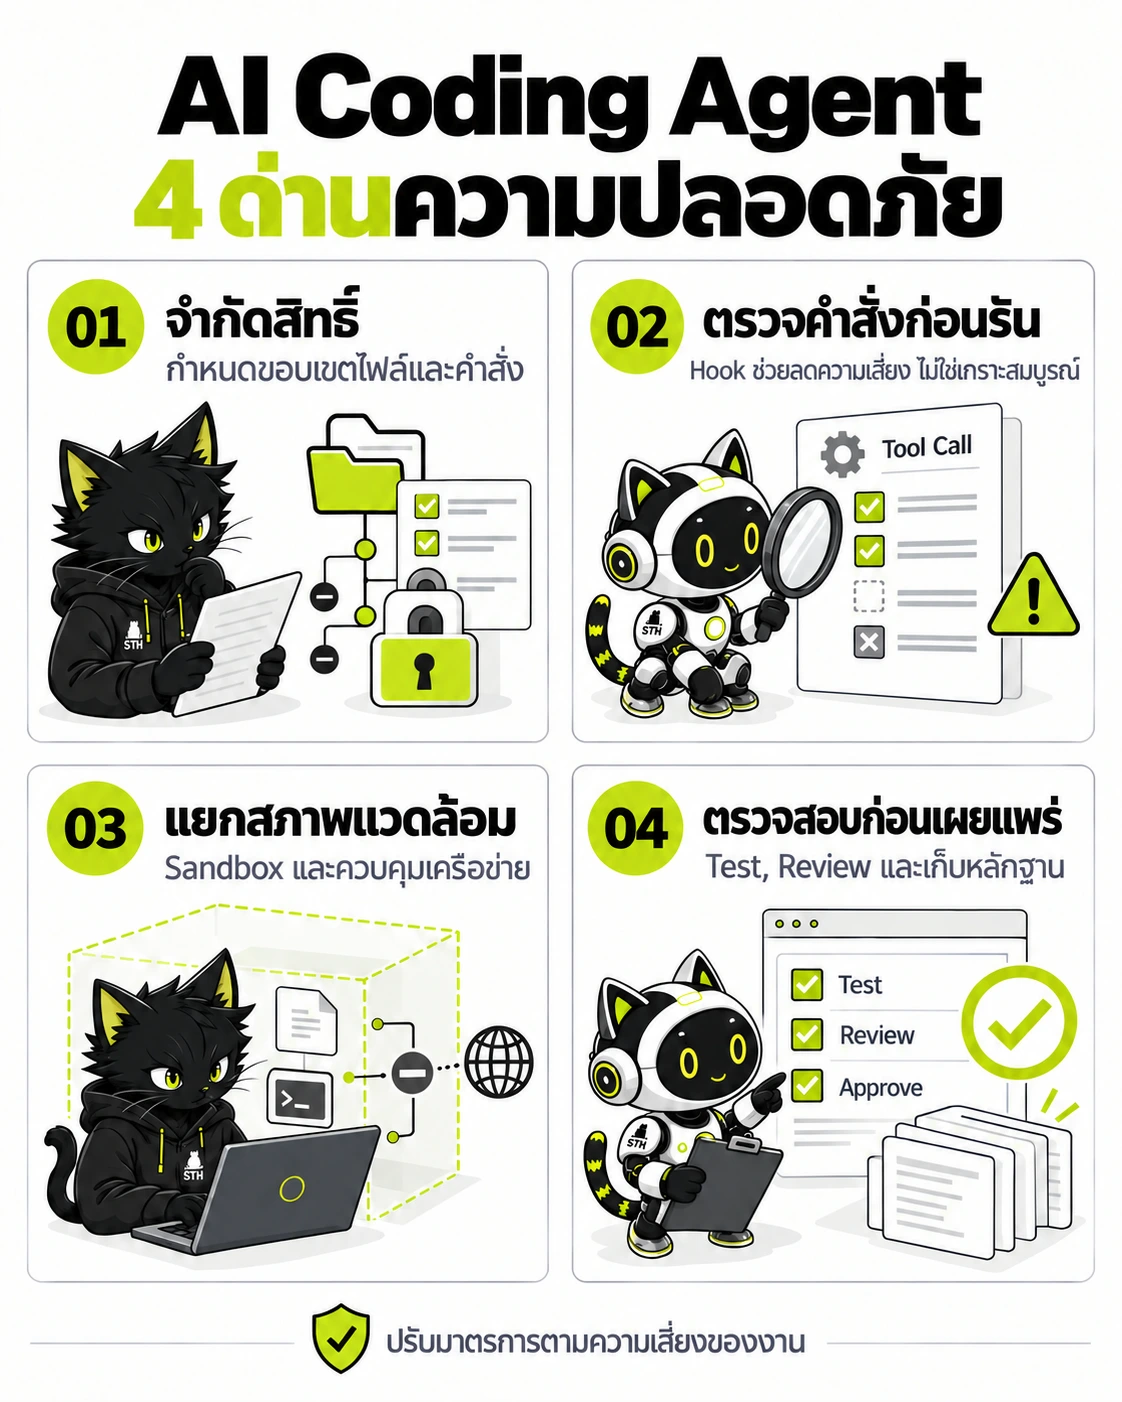
เลือกการจำกัดสิทธิ์ Hook, Sandbox และ Review ตามความเสี่ยง โดยตรวจขอบเขตจริงและไม่ถือว่ามาตรการใดป้องกันการโจมตีได้ทั้งหมด
- จำกัดสิทธิ์ — กำหนดขอบเขตไฟล์และคำสั่ง
- ตรวจคำสั่งก่อนรัน — Hook ช่วยลดความเสี่ยง ไม่ใช่เกราะสมบูรณ์
- แยกสภาพแวดล้อม — ใช้ Sandbox และควบคุมเครือข่าย
- ตรวจสอบก่อนเผยแพร่ — ทดสอบ Review และเก็บหลักฐาน
- Playbook เชื่อมการวางแผน ออกแบบ พัฒนา ทดสอบ เผยแพร่ และบำรุงรักษา โดยใช้ข้อกำหนดที่ตรวจสอบได้และหลักฐานจากการทำงาน
- Context Poisoning อาจเกิดเมื่อ Agent อ่านข้อความไม่น่าเชื่อถือจาก Repository, Issue หรือ Pull Request แล้วนำไปตีความเป็นคำสั่ง
- สิทธิ์อ่านไฟล์ รันคำสั่ง และเชื่อมเครือข่ายที่กว้างเกินงานอาจทำให้ข้อมูลหรือ Credential รั่วไหล แม้ Agent จะทำงานใน Workspace ที่กำหนด
- ตรวจชื่อ ที่มา และเวอร์ชันของ Dependency ที่ Agent เสนอ ไม่ถือว่าการมี Lockfile เพียงอย่างเดียวพิสูจน์ว่าแพ็กเกจปลอดภัย
- ประเมินความเสี่ยงของชุดคำสั่ง Agent Skill ตาม OWASP Agentic Skills Top 10 (โครงการระดับ OWASP Incubator ฉบับร่างรับฟังความคิดเห็น v1.0 ปี 2026 รหัส AST01 ถึง AST10) ซึ่งโครงการ OWASP อ้างถึงไฟล์ SKILL.md, skill.json และ manifest.json ตามแต่ละแพลตฟอร์ม เพื่อลดความเสี่ยงจาก Malicious Skill, Over-Privileged Skill และ Update Drift
จำกัดสิทธิ์และตรวจการเรียกใช้ Tool ก่อนดำเนินการ
ใช้ Permission, Approval และ Hook ที่เครื่องมือรองรับร่วมกัน โดยแยกข้อเสนอการควบคุมขององค์กรออกจากความสามารถจริงของแต่ละผลิตภัณฑ์
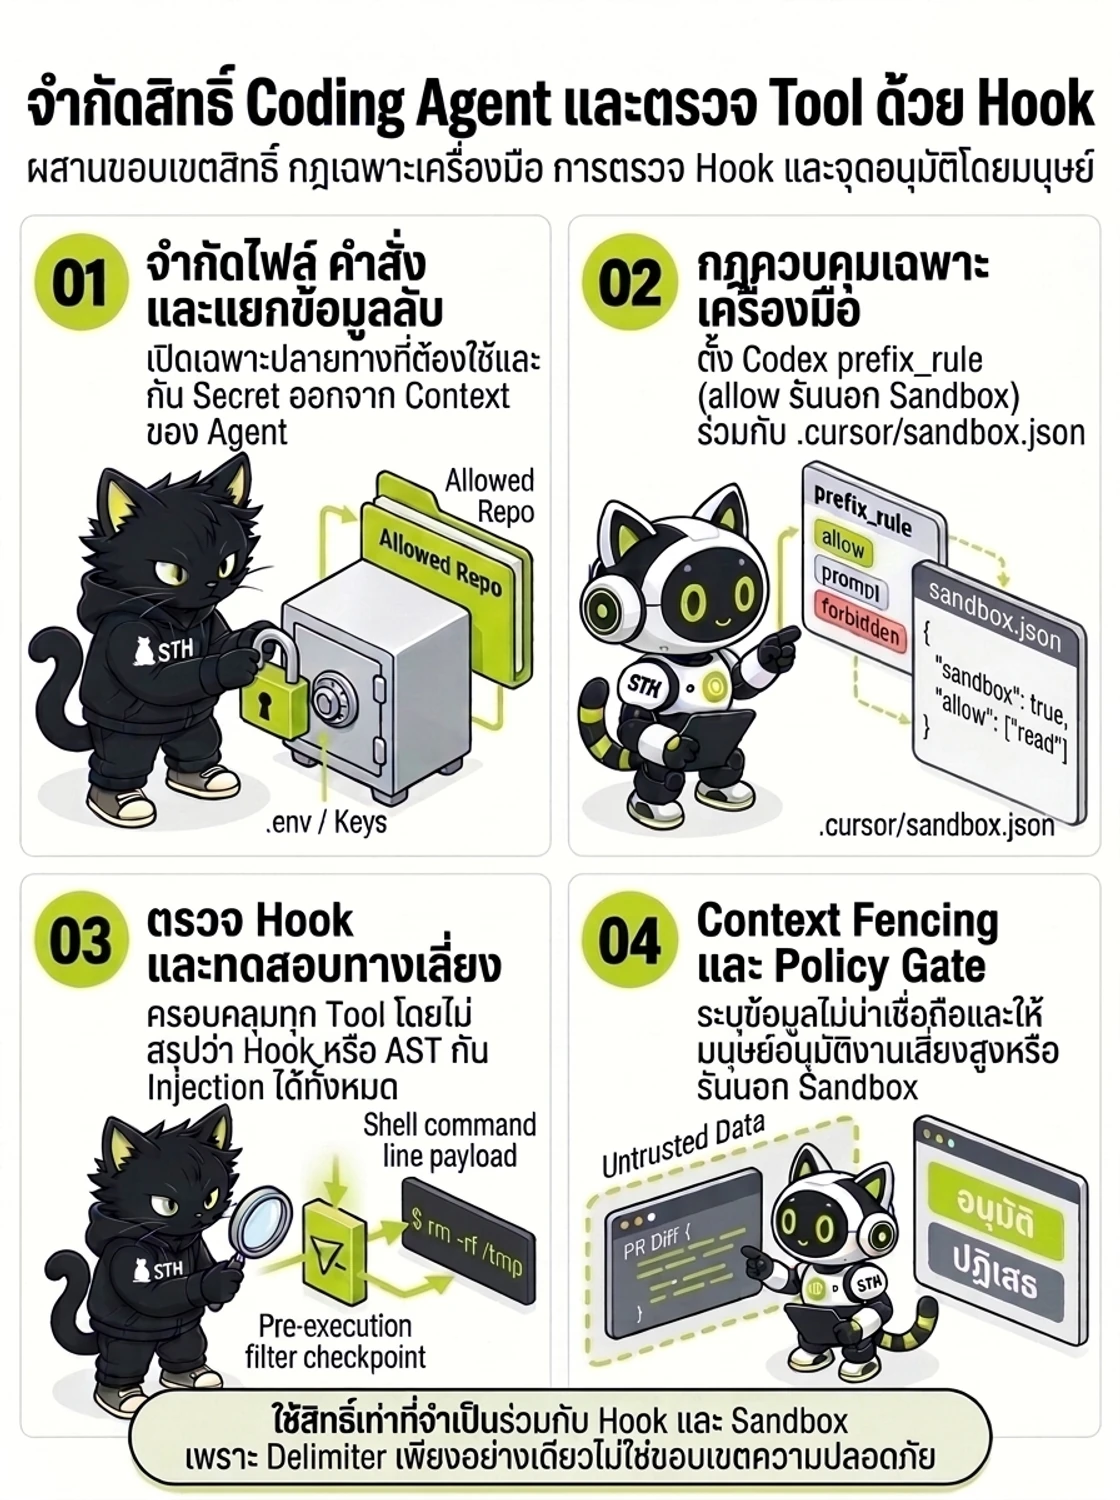
ใช้สิทธิ์เท่าที่จำเป็นร่วมกับ Hook และการแยกสภาพแวดล้อมจริง เพราะ Delimiter ใน Context เพียงอย่างเดียวไม่ใช่ขอบเขตความปลอดภัย
- จำกัดไฟล์ คำสั่ง และแยกข้อมูลลับ
กำหนดขอบเขตไฟล์และปลายทางเครือข่ายเท่าที่จำเป็นพร้อมกัน Secret ออกจาก Context - กฎควบคุมเฉพาะเครื่องมือ
ตั้งกฎตามเครื่องมือจริง เช่น prefix_rule ของ Codex ที่กฎ allow รันนอก Sandbox และ sandbox.json - ตรวจ Hook และทดสอบทางเลี่ยง
ครอบคลุม Tool ทุกตัวโดยไม่สรุปว่า Hook หรือ AST เพียงอย่างเดียวกัน Injection ได้ทั้งหมด - Context Fencing และจุดอนุมัติ
ทำเครื่องหมายข้อมูลไม่น่าเชื่อถือและให้มนุษย์อนุมัติงานเสี่ยงสูงหรืองานนอก Sandbox
- กำหนดขอบเขตไฟล์ คำสั่ง และปลายทางเครือข่ายเท่าที่งานต้องใช้ พร้อมแยกข้อมูลลับออกจาก Context และสภาพแวดล้อมของ Agent
- ตั้งค่ากฎควบคุมคำสั่งและไฟล์ตามความสามารถของเครื่องมือ เช่น กฎ prefix_rule ของ OpenAI Codex (allow, prompt, forbidden) ซึ่ง OpenAI ระบุว่าเป็นฟีเจอร์ทดลอง และ allow จะรันคำสั่งนอก Sandbox จึงควรจำกัดให้แคบ หรือการตั้งค่า Auto-review และไฟล์ .cursor/sandbox.json ของ Cursor ซึ่ง Cursor ระบุว่า Auto-review ไม่ใช่ขอบเขตความปลอดภัย จึงควรใช้ร่วมกับ Sandbox
- Hook ช่วยตรวจพารามิเตอร์และยับยั้งการกระทำที่ไม่อนุญาต แต่ต้องครอบคลุม Tool ที่เกี่ยวข้องและทดสอบเส้นทางเลี่ยง ไม่ถือว่า Hook หรือ AST ตรวจพบ Prompt Injection ได้ทุกกรณี
- Context Fencing ช่วยระบุว่าข้อความใดเป็นข้อมูลที่ไม่น่าเชื่อถือ แต่ Delimiter และ Prompt Sanitizer ไม่ใช่ขอบเขตความปลอดภัยที่ป้องกันการโจมตีได้สมบูรณ์
- กำหนดผู้อนุมัติหรือ Policy Gate สำหรับการกระทำที่มีผลกระทบสูง พร้อมตรวจการขอรันนอก Sandbox และการใช้สิทธิ์เกินขอบเขต
ตรวจขอบเขต Sandbox และเครือข่ายจากการทำงานจริง
ใช้กลไกที่เครื่องมือและระบบปฏิบัติการรองรับ และทดสอบขอบเขตจริง Container หรือชื่อโหมดไม่ใช่หลักฐานว่าป้องกันการเข้าถึง Host ได้ครบถ้วน
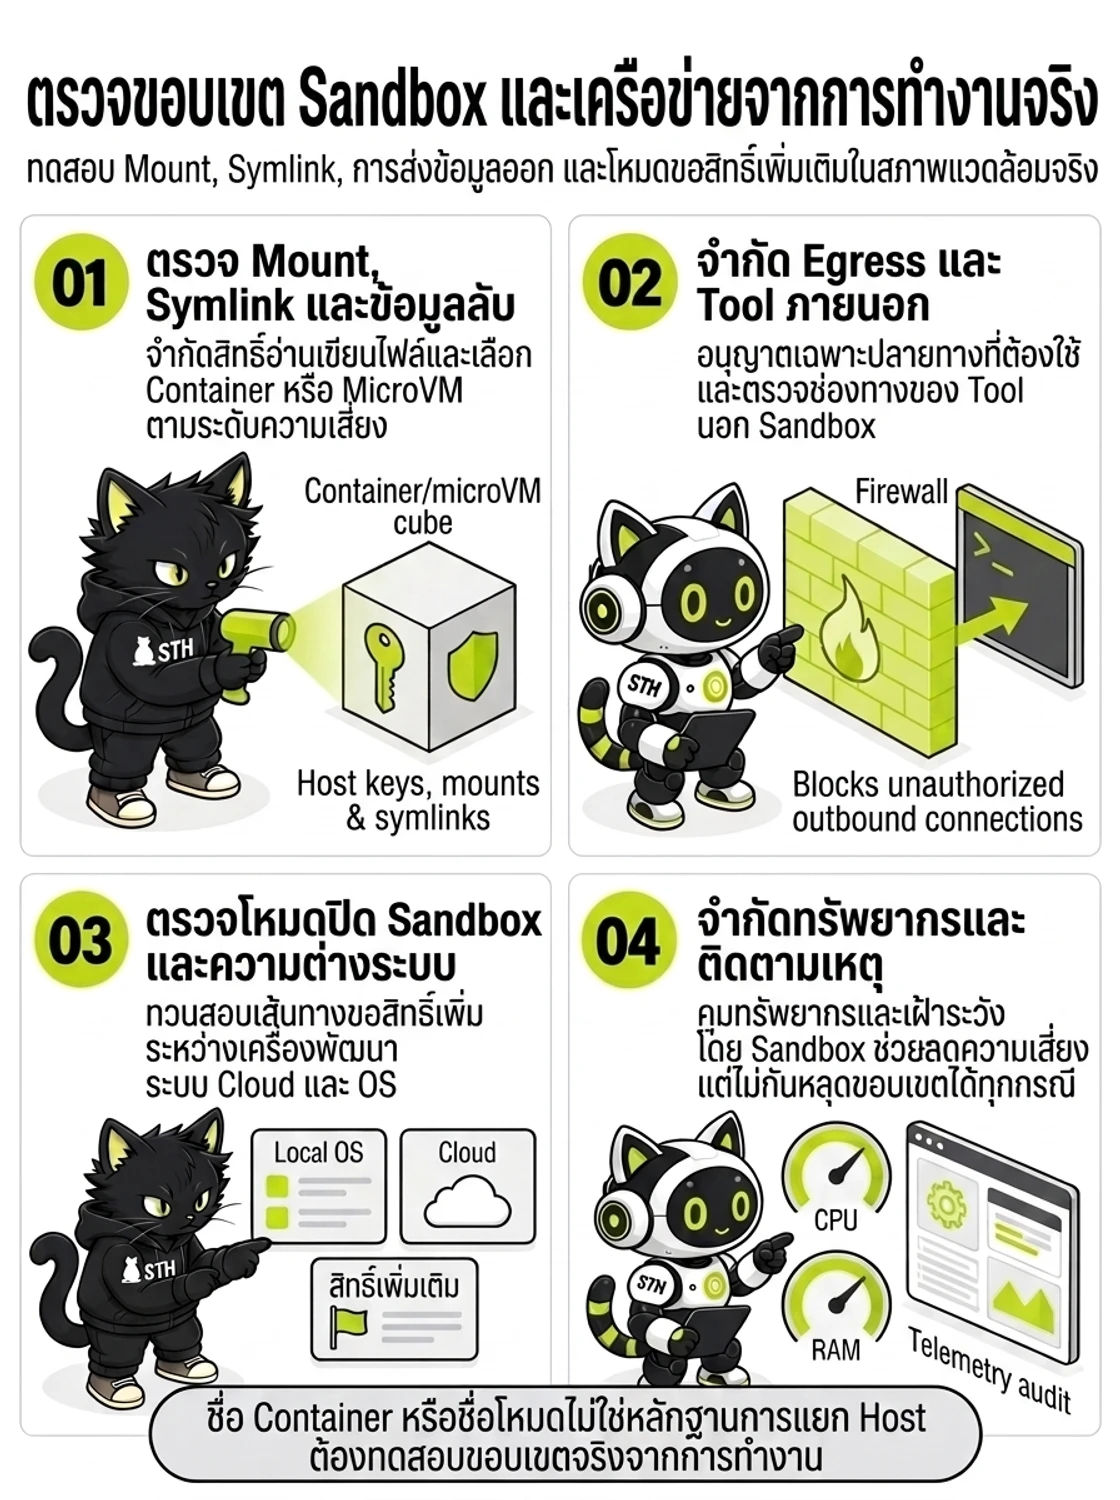
ชื่อ Container หรือชื่อโหมดไม่ได้พิสูจน์การแยก Host ต้องทดสอบ Mount, Symlink, Egress และช่องทางขอสิทธิ์จากการทำงานจริง
- ตรวจ Mount, Symlink และข้อมูลลับ
จำกัดสิทธิ์อ่านเขียนไฟล์และเลือก Container หรือ MicroVM ให้เหมาะกับระดับความเสี่ยง - จำกัด Egress และ Tool ภายนอก
อนุญาตเฉพาะปลายทางเครือข่ายที่จำเป็นและตรวจช่องทางของ Tool นอก Sandbox - ตรวจโหมดปิด Sandbox และความต่างระบบ
ทวนสอบเส้นทางขอสิทธิ์เพิ่มรวมถึงความต่างระหว่างเครื่องพัฒนา ระบบ Cloud และ OS - จำกัดทรัพยากรและติดตามเหตุ
ตั้งเพดาน CPU และ Disk พร้อมเก็บ Telemetry เนื่องจาก Sandbox ช่วยลดความเสี่ยงแต่ไม่ได้ป้องกันการหลุดขอบเขตทุกกรณี
- จำกัดการอ่านและเขียนไฟล์ ตรวจ Mount, Symlink และไฟล์ Credential ที่กระบวนการยังเข้าถึงได้ เลือก Container หรือ MicroVM เมื่อเหมาะกับความเสี่ยง
- จำกัดเครือข่ายขาออกและอนุญาตเฉพาะปลายทางที่งานต้องใช้ พร้อมตรวจช่องทางที่ Tool ภายนอก Sandbox อาจเข้าถึงได้
- ตรวจโหมดที่ปิด Sandbox การขอสิทธิ์เพิ่มเติม และความต่างระหว่างเครื่องพัฒนา ระบบ Cloud และระบบปฏิบัติการที่รองรับ
- กำหนดการจำกัดทรัพยากรและการติดตามเหตุที่เหมาะสม Sandbox ช่วยลดความเสี่ยงแต่ไม่ได้ป้องกันการหลุดขอบเขตได้ทุกกรณี
ทดสอบ Review และเก็บหลักฐานก่อนเผยแพร่
เลือกการทดสอบและระดับ Review ตามความเสี่ยงของการเปลี่ยนแปลง โดยให้ระบบ CI และผู้รับผิดชอบควบคุมการเผยแพร่ตามนโยบายองค์กร
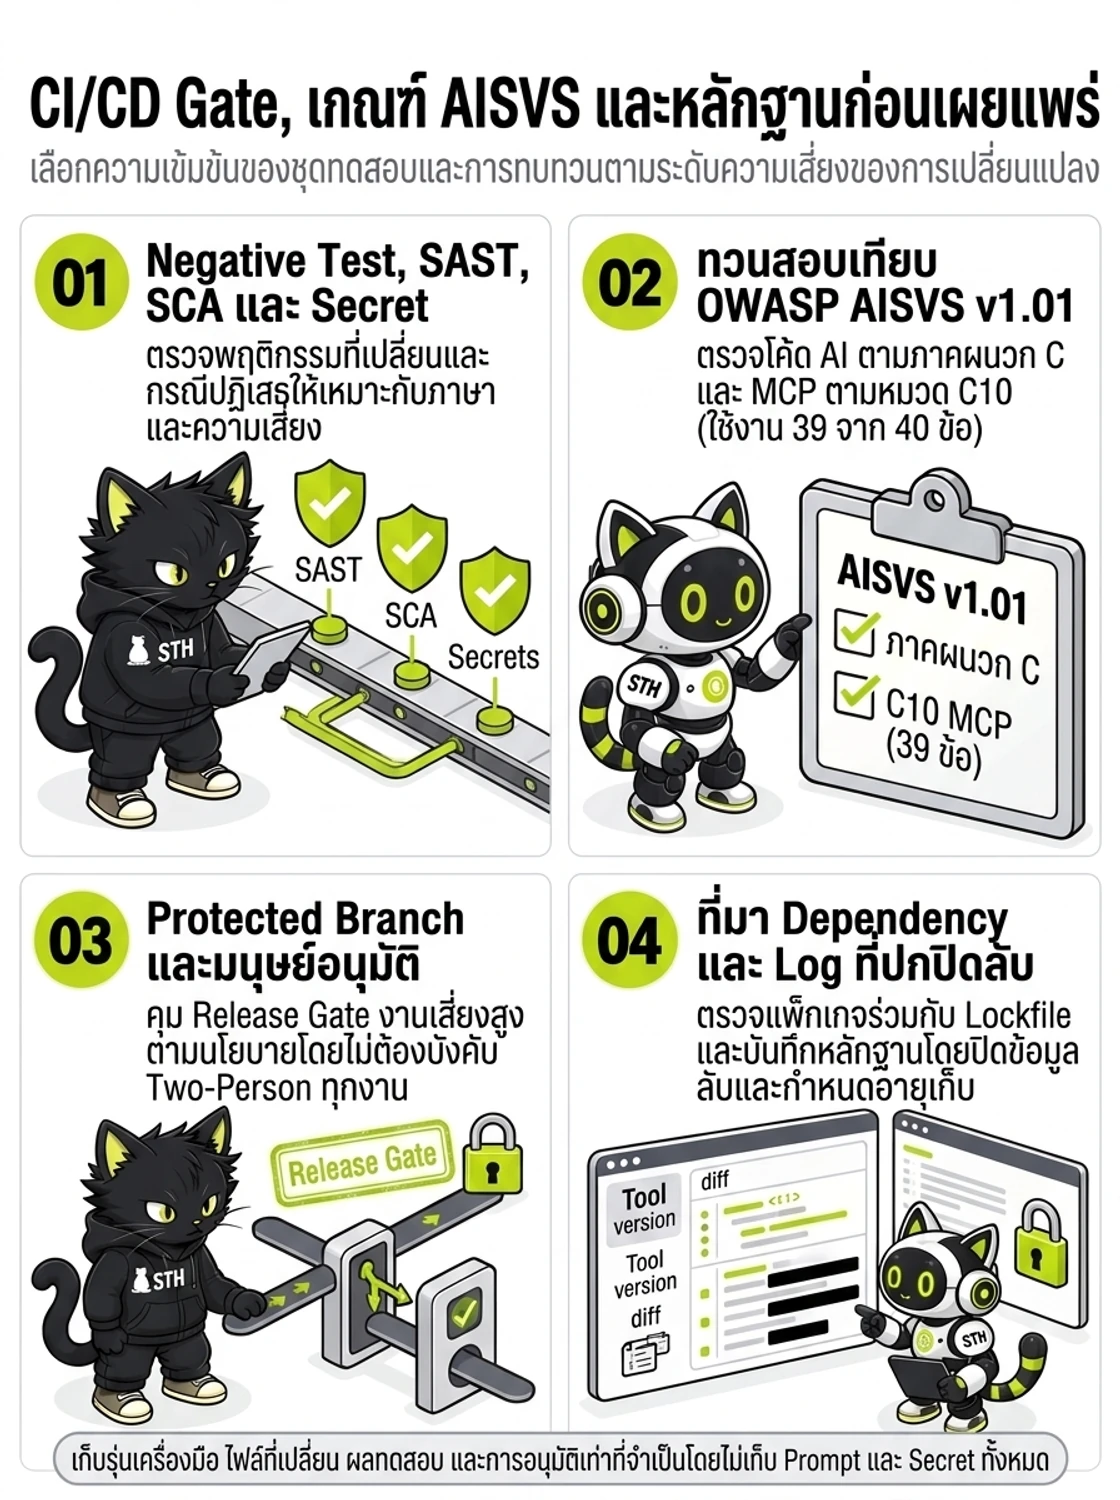
เก็บรุ่นเครื่องมือ, Diff, ผลการทดสอบ และหลักฐานการอนุมัติไว้ทวนสอบโดยไม่ต้องเก็บ Prompt ดิบหรือบังคับรูปแบบเดียวทุกการเปลี่ยนแปลง
- Negative Test, SAST, SCA และ Secret
ทดสอบพฤติกรรมที่เปลี่ยนและกรณีปฏิเสธร่วมกับการสแกนที่เหมาะกับภาษาและความเสี่ยง - ทวนสอบเทียบ OWASP AISVS v1.01
ตรวจโค้ดที่สร้างโดย AI ตามภาคผนวก C และตรวจ MCP ตามหมวด C10 ที่ใช้งาน 39 จาก 40 ข้อ - Protected Branch และมนุษย์อนุมัติ
กำหนด Release Gate งานเสี่ยงสูงตามนโยบายโดยไม่บังคับ Two-Person Review แบบเดียวทุกงาน - ที่มา Dependency และ Log ที่ปกปิดลับ
ตรวจแพ็กเกจร่วมกับ Lockfile และบันทึกหลักฐานโดยปกปิด Secret พร้อมกำหนดอายุจัดเก็บ
- ตรวจพฤติกรรมที่เปลี่ยนและกรณีปฏิเสธที่เกี่ยวข้อง ใช้ SAST, SCA และ Secret Scanning เมื่อเหมาะกับภาษา ขอบเขต และความเสี่ยง
- ทวนสอบโค้ดที่สร้างโดย AI และการเชื่อมต่อ MCP Server เทียบกับแนวทาง OWASP AISVS v1.01 ภาคผนวก C (AI-Assisted Secure Coding) และหมวด C10 (MCP Security 40 รหัสข้อกำหนด ใช้งานอยู่ 39 ข้อ)
- ใช้ Protected Branch และ Release Gate ตามนโยบาย ให้มนุษย์ Review การเปลี่ยนแปลงที่มีผลกระทบสูง Playbook ของ Anthropic ไม่ได้กำหนด Two-Person Rule สำหรับทุกงาน
- ตรวจความถูกต้องและที่มาของ Dependency ร่วมกับ Lockfile และผลการทดสอบ Subresource Integrity ไม่ใช่กลไกตรวจสอบ Dependency ทุกชนิด
- เก็บหลักฐานรุ่นเครื่องมือ ไฟล์ที่เปลี่ยน ผลทดสอบ และการอนุมัติเท่าที่จำเป็น พร้อมปกปิดข้อมูลลับและกำหนดอายุการเก็บ ไม่เก็บ Prompt และ Tool Parameter ทั้งหมดโดยไม่มีการคัดกรอง
ตารางอ้างอิงและขอบเขตการประเมิน
สรุปเอกสารอ้างอิง ขอบเขตการประเมิน และรอบทบทวนตามบริบทของแต่ละรายการ
| เอกสารอ้างอิง | สาระสำคัญ | ขอบเขตการทดสอบ | รอบเวลาทดสอบ |
|---|---|---|---|
| Anthropic AI-Native SDLC Playbook | AI-Native SDLC เป็นแนวทางวิศวกรรม ไม่ใช่มาตรฐานกำกับ | คู่มือนี้อ้าง Anthropic AI-Native SDLC Playbook และเอกสารความปลอดภัยของเครื่องมือ AI Coding Agent เพื่อเสนอการควบคุมตามความเสี่ยง ไม่ใช่กฎหมายหรือการรับรองมาตรฐาน | ตามขอบเขตมาตรฐานและความเสี่ยงของบริการ ไม่ใช่รอบทดสอบตายตัว |
| เอกสาร Permission และ Hook ของผู้ผลิต | จำกัดสิทธิ์และตรวจการเรียกใช้ Tool ก่อนดำเนินการ | ใช้ Permission, Approval และ Hook ที่เครื่องมือรองรับร่วมกัน โดยแยกข้อเสนอการควบคุมขององค์กรออกจากความสามารถจริงของแต่ละผลิตภัณฑ์ | ตามขอบเขตมาตรฐานและความเสี่ยงของบริการ ไม่ใช่รอบทดสอบตายตัว |
| เอกสาร Sandbox ของผู้ผลิต | ตรวจขอบเขต Sandbox และเครือข่ายจากการทำงานจริง | ใช้กลไกที่เครื่องมือและระบบปฏิบัติการรองรับ และทดสอบขอบเขตจริง Container หรือชื่อโหมดไม่ใช่หลักฐานว่าป้องกันการเข้าถึง Host ได้ครบถ้วน | ตามขอบเขตมาตรฐานและความเสี่ยงของบริการ ไม่ใช่รอบทดสอบตายตัว |
| ข้อเสนอ Release Gate ของ STH | ทดสอบ Review และเก็บหลักฐานก่อนเผยแพร่ | เลือกการทดสอบและระดับ Review ตามความเสี่ยงของการเปลี่ยนแปลง โดยให้ระบบ CI และผู้รับผิดชอบควบคุมการเผยแพร่ตามนโยบายองค์กร | ตามขอบเขตมาตรฐานและความเสี่ยงของบริการ ไม่ใช่รอบทดสอบตายตัว |
รายการติดตามการดำเนินงาน
เลือกรายการที่องค์กรดำเนินการแล้ว เปอร์เซ็นต์แสดงสัดส่วนรายการที่เลือกเท่านั้น ไม่ใช่ผลประเมินความปลอดภัยหรือการปฏิบัติตามข้อกำหนด
คำถามที่พบบ่อย (FAQ)
คำถามและข้อสงสัยสำคัญเกี่ยวกับข้อกำหนดและการตรวจประเมินตามมาตรฐาน
Context Poisoning เกิดขึ้นได้อย่างไร?
Context Poisoning อาจเกิดเมื่อ Agent อ่านข้อความไม่น่าเชื่อถือจาก Repository, Issue หรือ Pull Request แล้วนำไปตีความเป็นคำสั่ง
Hook และ Context Fencing ป้องกัน Prompt Injection ได้ทั้งหมดหรือไม่?
Hook ช่วยตรวจพารามิเตอร์และยับยั้งการกระทำที่ไม่อนุญาต แต่ต้องครอบคลุม Tool ที่เกี่ยวข้องและทดสอบเส้นทางเลี่ยง ไม่ถือว่า Hook หรือ AST ตรวจพบ Prompt Injection ได้ทุกกรณี Context Fencing ช่วยระบุว่าข้อความใดเป็นข้อมูลที่ไม่น่าเชื่อถือ แต่ Delimiter และ Prompt Sanitizer ไม่ใช่ขอบเขตความปลอดภัยที่ป้องกันการโจมตีได้สมบูรณ์
Container หรือ Sandbox ป้องกันความเสี่ยงทั้งหมดหรือไม่?
ใช้กลไกที่เครื่องมือและระบบปฏิบัติการรองรับ และทดสอบขอบเขตจริง Container หรือชื่อโหมดไม่ใช่หลักฐานว่าป้องกันการเข้าถึง Host ได้ครบถ้วน จำกัดเครือข่ายขาออกและอนุญาตเฉพาะปลายทางที่งานต้องใช้ พร้อมตรวจช่องทางที่ Tool ภายนอก Sandbox อาจเข้าถึงได้